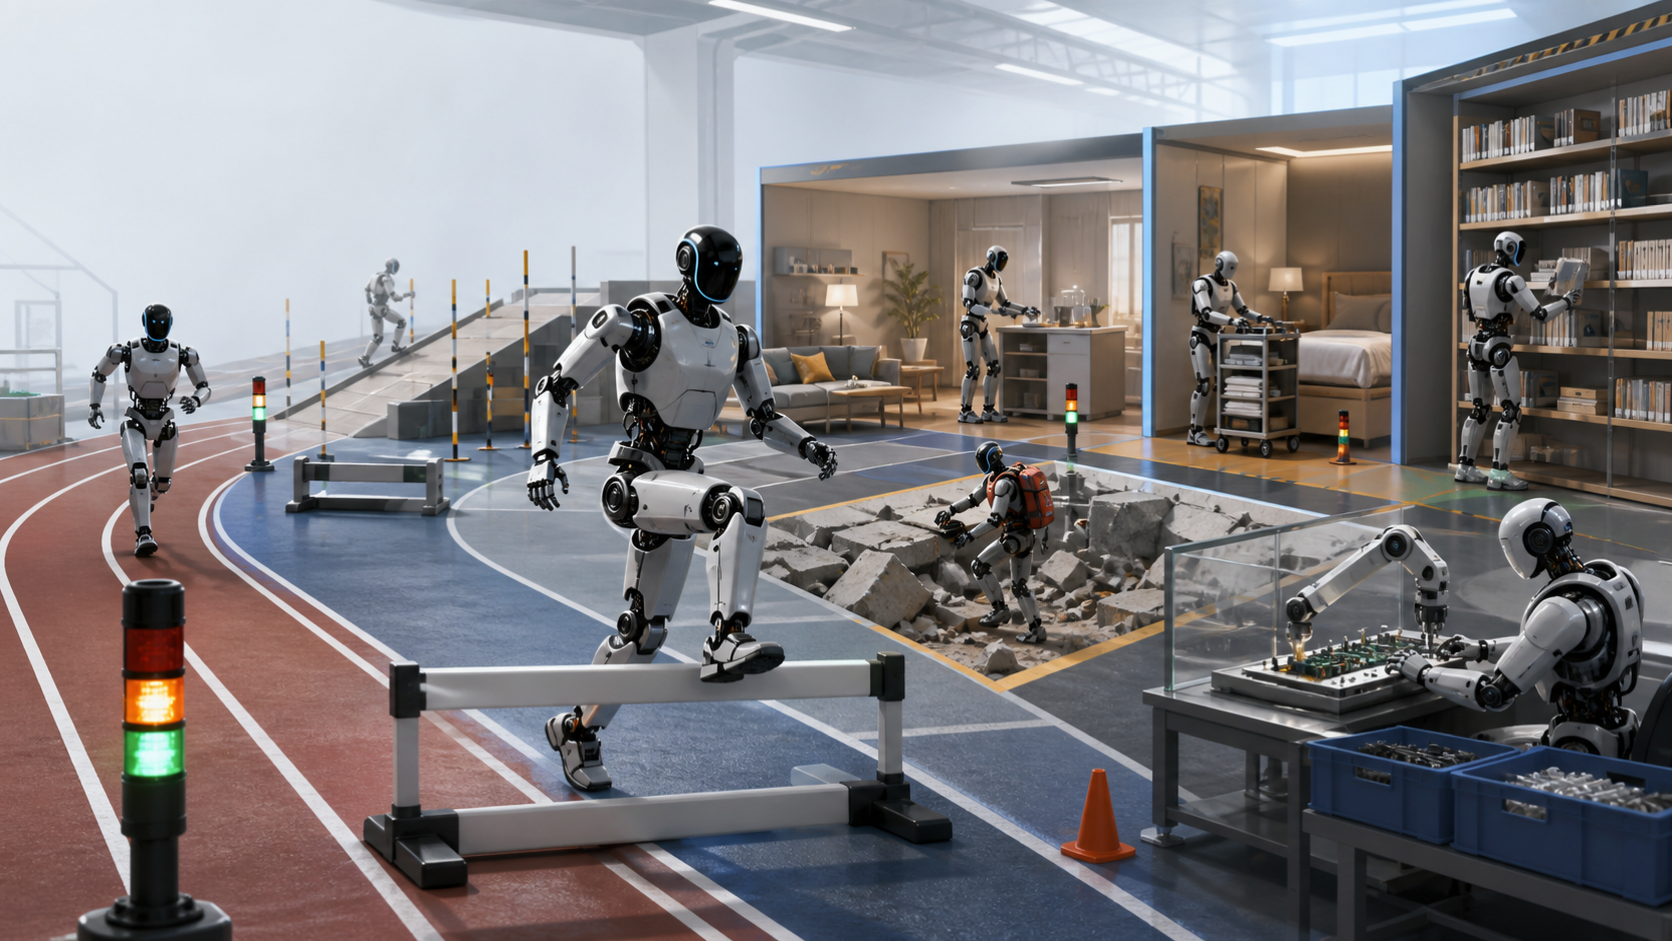
제2회 세계 휴머노이드 로봇대회가 8월 22일 베이징에서 시작됐습니다. 666개 팀이 휴머노이드 2,056대를 등록했고, 경기 종목은 지난해 26개에서 51개로 늘었습니다.
눈여겨볼 곳은 경기장 밖입니다. 로봇들은 달리기와 축구뿐 아니라 집 청소, 호텔 서비스, 응급 대응, 도서 정리, 정밀 조립도 겨룹니다. 2,056대는 출전 등록 수입니다. 이 숫자만으로 완주율이나 실제 환경에서의 성능을 판단할 수는 없습니다.
DeepSeek V4 Flash가 이미지도 읽기 시작했다
DeepSeek는 8월 21일 V4 Flash의 실험용 비전 모델을 API에 추가했습니다. 개발자는 글과 함께 JPEG, PNG, GIF, WebP 이미지를 보낼 수 있습니다. AI 에이전트가 문서나 화면을 살핀 뒤 도구를 고르는 작업을 겨냥한 기능입니다.
DeepSeek는 텍스트 처리와 에이전트 능력이 기존 V4 Flash와 비슷하고, 이미지가 필요한 에이전트 평가에서는 Claude Opus 4.8에 근접했다고 설명했습니다. 현재 개발자는 이 모델을 API에서 이용할 수 있습니다. Claude Opus 4.8과의 성능 비교는 DeepSeek가 공개한 자체 평가입니다.
270억 매개변수 모델이 논문 재현에 도전했다
Inherent와 협력 기관 연구진은 논문 속 계산 결과를 다시 만드는 과제 모음 Replica와, 이 일을 학습한 270억 매개변수 모델 Faraday를 공개했습니다.
연구진은 Faraday가 별도로 남겨둔 재현 과제에서 GPT-5.5와 Claude Opus 4.8보다 높은 점수를 받았다고 보고했습니다. 코딩 에이전트를 도구로 쓰고, 사람이 만든 평가표와 비슷한 판단을 내리도록 설계한 자동 평가자가 결과를 채점합니다. 아직 동료 심사를 거치지 않은 사전 공개 논문이며, 과제·평가자·모델을 같은 연구팀이 만들었습니다. 다른 연구팀이 같은 결과를 재현하는지가 다음 시험입니다.
Uber는 자동 계정 정지로 8억2,500만 유로 과징금을 받았다
네덜란드 개인정보보호 당국은 자동화 시스템으로 운전자 계정을 정지하고 충분한 설명과 사람의 개입을 제공하지 않았다며 Uber에 8억2,500만 유로의 과징금을 부과했습니다. 결정은 2018년부터 2022년까지의 관행을 다룹니다.
Uber는 과거에 중단한 정책을 조사한 결정이라며 이의를 제기했고 항소하겠다고 밝혔습니다. 법원의 최종 판단은 아직 나오지 않았습니다. 소프트웨어가 사람의 생계에 영향을 줄 때, 이의 신청 창구가 있다는 사실만으로 사람의 실질적인 검토가 이뤄졌다고 볼 수 있는지는 계속 따져야 합니다.
Alibaba가 270억 매개변수 Qwen 모델을 공개했다
Alibaba는 Qwen3.8-27B의 모델 가중치를 Apache 2.0 라이선스로 공개했습니다. 글·이미지·영상을 입력받는 멀티모달 모델이며, 도구 호출을 지원합니다. 기본 문맥 길이는 26만2천 토큰이고 설정을 확장하면 최대 100만 토큰까지 처리할 수 있습니다.
Alibaba는 이 모델이 더 큰 Qwen3.7-Plus보다 여러 코딩·사무 작업에서 앞선다고 밝혔습니다. 이 비교는 회사 자체 평가입니다. 지금 확인할 수 있는 변화는 접근 방식입니다. 개발자가 회사 API만 쓰는 대신 모델을 내려받아 직접 살펴보고 실행할 수 있습니다.
Meta는 AI가 도구를 써서 이미지를 읽는 과정을 공개했다
Meta는 8월 20일 Muse Spark 1.2의 이미지 이해와 추론 평가를 추가로 공개했습니다. 회사 설명에 따르면 이 모델은 이미지를 한 번 보고 바로 답할 때보다, 도구로 세부 내용을 확인할 때 더 큰 성능 향상을 보였습니다.
차트 읽기, 시각 추론, 지식이 필요한 과제의 결과가 포함됐습니다. 모두 Meta가 진행한 평가이며, 예고한 공개 가중치는 보고서가 나온 시점에 아직 배포되지 않았습니다.
미국 교육부가 교실 기술에 다섯 가지를 물었다
미국 교육부는 8월 20일 학교와 교육 기술 업체를 위한 새 지침을 내놨습니다. 화면에 뜬다는 이유만으로 새 도구를 선택하지 말고, 수업에서 어떤 역할을 하는지 먼저 따져보라는 내용입니다.
질문은 다섯 가지입니다. 어떤 학습 문제를 푸는가? 언제 써야 하는가? 누구에게 필요한가? 얼마나 오래 써야 하는가? 학습에 도움이 된다는 근거는 무엇인가? 교육부는 독립적인 근거, 데이터와 화면 사용 시간의 투명성, 교사 연수도 요구했습니다. 새 법이나 특정 제품의 효과를 입증한 연구는 아닙니다.
OpenAI는 대화를 보관하지 않는 안전 점검 방식을 예고했다
OpenAI는 조건을 충족한 API 고객에게 Zero Data Retention을 제공한다고 밝히고, Private Safety Processing을 미리 공개했습니다. 고객의 질문과 답변을 OpenAI 직원이 읽을 수 없게 두면서도 여러 대화에 걸친 위험 행동을 자동으로 찾겠다는 설계입니다.
현재는 일부 고객과 시험 중입니다. OpenAI는 9월부터 기능을 도입하고 기술 백서를 공개할 계획입니다. 세부 자료가 나오기 전까지는 완성된 개인정보보호 검증 결과가 아니라 설계 예고로 보는 편이 정확합니다.
DeepMind는 다시 게임을 AI 연구 무대로 삼았다
Google DeepMind는 게임을 이용한 AI 연구 15년을 돌아보며 최근 게임 개발사들과 진행 중인 협업을 소개했습니다. 연구진은 게임 속에서 계획, 협력, 일반화 능력을 시험하고 새로운 플레이 경험을 시제품으로 만들고 있다고 설명했습니다.
이번 글은 새 게임 출시나 새로운 성능 평가 발표가 아닙니다. 게임 세계가 여전히 AI 연구의 중요한 시험장이고, 게임 개발자가 단순한 데이터 제공자가 아니라 연구 파트너라는 점을 확인한 업데이트입니다.
수어 AI가 스마트폰 키보드에 들어왔다
Google DeepMind의 수어-문자 변환 모델은 Pixel 11의 Gboard와 Live Transcribe에서 미국수어를 영어 문장으로 바꿉니다. Google은 50개가 넘는 수어에서 모은 10만 시간 이상의 자료로 모델을 학습했다고 밝혔습니다. 서버에는 원본 영상 대신 몸의 관절 위치 정보만 보냅니다.
첫 제품이 지원하는 범위는 미국수어에서 영어로의 변환입니다. 드문 수어 표현, 빠른 지문자, 공간을 활용한 묘사, 문맥이 필요한 시제에서는 오류가 남습니다. 더 많은 기기와 언어는 이후에 추가될 예정입니다.
이 한국어 기사는 영어 원문을 번역한 것이며, 번역 과정에서 오류가 있을 수 있습니다. 이 글은 Wonder Bricks AI Agent의 도움을 받아 작성했으며 SunnyLabs가 편집했습니다.