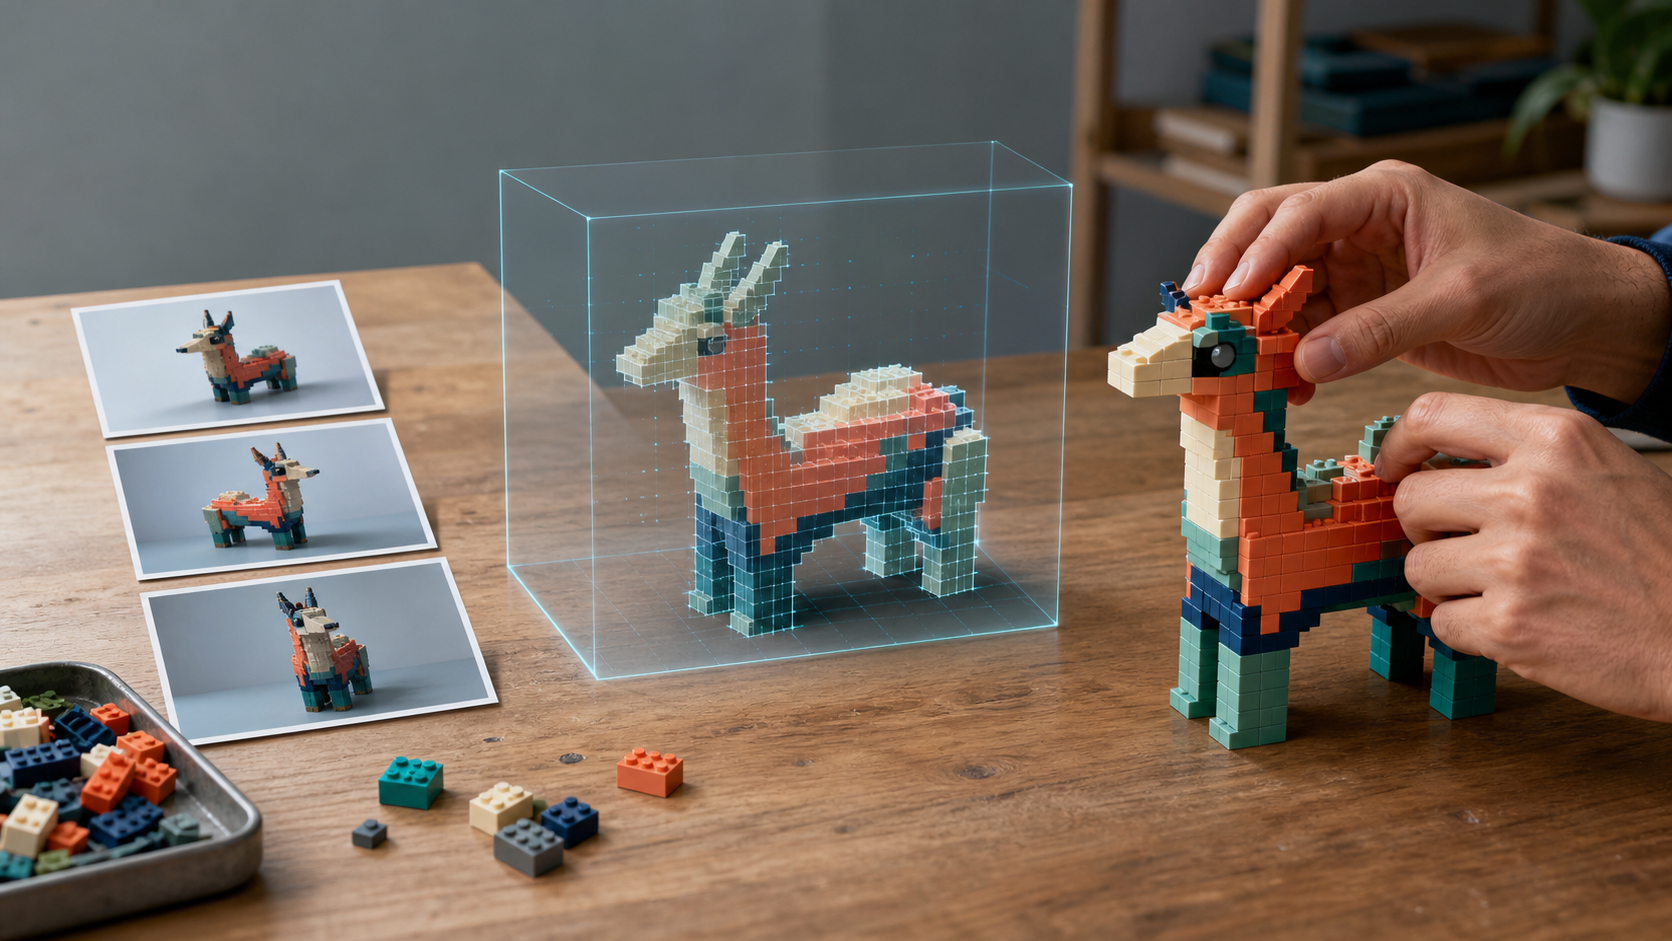
사진 몇 장만으로 그럴듯한 3D 모형을 만드는 일은 이미 가능해졌습니다. 새 연구는 한 걸음 더 나아갑니다. 사진을 닮은 모형을 만들면서, 실제 벽돌로 쌓았을 때 무너지지 않게 할 수 있을까요?
ResemBrick은 닮은 정도와 구조의 안정성을 하나의 문제로 계산합니다. 연구진은 비교한 벽돌 제작 시스템 가운데 사진과 가장 비슷한 결과를 냈고, 별도 평가용 물체에서는 공중에 뜨거나 불안정한 벽돌이 하나도 없었다고 보고했습니다. 아직 소비자용 제품의 성능을 증명한 것은 아니지만, ‘만들 수 있어 보이는 그림’과 ‘실제로 만들 수 있는 설계’의 차이를 선명하게 보여줍니다.
사진을 보고, 무너지지 않는 모형을 만들다
벽돌 수가 제한되면 무엇을 살릴지 정해야 한다
ResemBrick은 물체를 여러 각도에서 가볍게 찍은 사진으로 시작합니다. 일반적인 3D 복원은 물체 표면을 추정한 뒤 작은 정육면체 격자로 바꿀 수 있습니다. 격자가 거칠수록 선택은 어려워집니다. 뿔이나 곡선을 살리는 데 벽돌을 많이 쓰면 다른 부분이 단순해지고, 겉모양은 비슷해도 받칠 곳이 없는 조각이 생길 수 있습니다.
연구진은 사용할 수 있는 격자 칸을 예산처럼 다뤘습니다. 하나의 신경망이 13가지 해상도에서 어느 표면을 채울지 결정합니다. 보이는 세부를 무조건 많이 복사하는 것이 아니라, 주어진 벽돌 수 안에서 물체의 특징을 가장 잘 남기는 곳에 벽돌을 배분합니다.
안정성은 마지막 검사보다 조립 과정에 가깝다
다음 과정은 지금 놓는 벽돌이 바로 지지되는지, 뒤이어 놓을 벽돌과 어떻게 이어지는지를 함께 살핍니다. 그래도 떠 있는 부분이 생기면, 정해진 보정 절차가 바닥과 연결합니다. 연구진은 이 절차가 반드시 끝난다는 점을 수학적으로 보였고, 공개한 평가에서는 떠 있거나 불안정한 벽돌이 없었습니다.
이 결과의 범위는 분명합니다. 논문이 사용한 데이터, 벽돌 종류, 평가 방식, 비교 대상 안에서 나온 수치입니다. 어떤 휴대전화 사진이든 보기 좋은 모형으로 바뀐다는 뜻은 아닙니다. 아이가 별도 설명 없이 바로 조립할 수 있는지, 실제 디자인 도구로 출시할 준비가 됐는지도 아직 알 수 없습니다.
그래도 생성 AI를 평가하는 기준 하나는 잘 보여줍니다. 화면에서 멋져 보이는 것만으로는 충분하지 않습니다. 화면 밖으로 나올 물건이라면 재료의 한계, 지지 구조, 조립 순서, 직접 만들 사람까지 견뎌야 합니다.
함께 볼 네 가지 변화
Dark Souls 보스 22명 앞에서 게임 AI의 실력이 드러났다
Dark Souls Learning Environment, 줄여서 DSLE는 Dark Souls: Remastered의 보스전 22개를 AI가 플레이할 수 있는 실험 환경으로 만들었습니다. AI가 내리는 결정은 실제 실행 중인 게임의 동작으로 이어집니다. 화면을 보고, 실시간으로 싸우고, 보상을 자주 받지 못하는 상황을 함께 처리해야 합니다.
연구진은 성격이 다른 보스 다섯을 시작용 묶음으로 정하고 무작위 정책, 전문가 시스템, 진화 방식, PPO, DQN을 비교했습니다. 전문가 시스템과 진화 방식은 입문 보스인 Asylum Demon을 최고 63%, 43%의 비율로 이겼습니다. 다섯 접근법 모두 나머지 보스 넷은 이기지 못했습니다. PPO와 DQN은 연구진이 정한 학습 시간 안에서 입문 보스 승률도 최고 0.33%였고, 다른 보스에게는 한 번도 이기지 못했습니다.
게임 하나와 정해진 입력 방식, 학습 시간 안에서 얻은 결과입니다. AI가 복잡한 게임을 배울 수 없다는 뜻은 아닙니다. 짧은 성공 영상 너머에서 시각, 타이밍, 이동, 생존을 얼마나 오래 함께 유지하는지 반복해서 비교할 시험장이 생겼다는 뜻입니다.
과학 영상은 매끄러워 보여도 움직임의 원리를 틀릴 수 있다
Sci-VBench는 자연과학, 보건의료, 인문사회, 공학 60개 주제에서 전문가가 검토한 영상 생성 과제 1,253개를 모았습니다. 한 장면을 보기 좋게 그리는 데서 끝나지 않고, 시간이 지나도 과학 지식과 원인·결과가 맞게 이어지는지를 봅니다.
연구진이 상용·공개 모델 16개를 시험하자 겉보기 품질 점수는 비교적 비슷하게 모였습니다. 반면 지시를 정확히 따랐는지, 과학적 설명과 인과관계가 맞는지는 모델마다 큰 차이가 났습니다. 보기 좋은 정도만으로는 설명이 옳은지 판단하기 어려웠습니다.
이 연구는 생성 영상이 교실에서 학습 효과를 높이는지 시험하지 않았습니다. 그보다 앞선 기준을 제시합니다. 움직이는 영상을 설명 자료로 쓰기 전에는, 그 움직임이 가르치려는 원리를 실제로 따르는지 사람이 확인해야 합니다.
문장은 작가가 썼다. AI는 작가가 모르는 부분을 짚었다
VeriForge는 보통의 글쓰기 AI가 놓치기 쉬운 문제에서 출발합니다. 작가가 무엇을 모르는지조차 모르면 검색어도 떠올리기 어렵습니다. 이 시스템은 초고를 쓰는 동안 지식이 빠졌을 수 있는 부분을 표시하고, 대화형 답변과 출처가 붙은 자료 카드를 함께 보여줍니다. 찾은 자료를 정리하는 공간도 제공합니다. 어떤 내용을 쓸지 결정하고 문장을 완성하는 일은 작가에게 남겨둡니다.
연구진은 소설가 아홉 명과 먼저 인터뷰했고, 작가 12명이 두 방식을 모두 써보는 실험을 진행했습니다. 참가자는 미처 생각하지 못한 지식의 빈틈을 더 잘 발견했고, 낯선 내용을 탐색하는 데 도움을 받았다고 보고했습니다. 전문가 평가는 통제된 글쓰기 과제에서 해당 분야의 세부가 더 잘 반영됐다고 봤습니다.
참가자 12명의 짧은 실험만으로 모든 작가에게 맞는 방법이나 장기적인 글쓰기 향상을 말할 수는 없습니다. 아이의 학습 효과를 확인한 연구도 아닙니다. 이 연구가 보여주는 것은 더 구체적인 역할 분담입니다. AI가 먼저 조사할 질문을 찾아도, 이야기의 목소리와 자료를 엮는 판단은 사람이 맡을 수 있습니다.
교육 AI 종합 점수 하나로는 네 가지 강점을 볼 수 없었다
ELBench는 범용 모델과 교육 특화 모델 아홉 개를 일반 능력, 안전과 신뢰, 기초 교육, 높은 수준의 사고를 기르는 과제라는 네 영역에서 평가했습니다.
상위 모델 여섯 개는 종합 점수만 보면 통계적으로 차이가 없었습니다. 그러나 각 영역의 1위는 달랐습니다. 논문은 안전 영역과 실제 교수 능력 영역 사이에 음의 상관관계가 있었다고 보고했고, 교육 특화 모델 두 개는 교육 영역 두 곳 모두 1위를 차지하지 못했습니다. 높은 수준의 판단을 묻는 과제 하나에서는 모든 모델이 학습 목표에 맞는 답보다 교육적으로 그럴듯한 표현을 택하는 같은 오류를 보였습니다.
새 사전 공개 논문 하나와 그 연구진이 만든 시험에서 나온 결과입니다. 모든 교육과정과 교실에 가장 좋은 AI를 정해주지는 않습니다. 그래도 ‘교육용’이라는 이름이나 평균 점수 하나만 볼 수 없는 이유는 보여줍니다. 어떤 학생에게, 어떤 능력을 위해, 어떤 교육적 판단을 도울 것인지가 먼저 정해져야 합니다.
첫 결과 다음에 무엇을 견뎌야 하는가
오늘 다룬 연구는 서로 다른 시스템을 시험하지만, 모두 첫인상 다음을 봅니다. 벽돌 모형은 서 있어야 합니다. 게임 AI는 보스전 전체를 버텨야 합니다. 과학 영상은 원인과 움직임을 맞게 이어야 합니다. 글쓰기 AI는 작가의 목소리를 삼키지 않고 도와야 합니다. 교육 AI는 실제로 필요한 교육 과제에 맞아야 합니다.
새로운 AI 소식을 볼 때도 이렇게 물어볼 수 있습니다. 무엇을 만들었는가? 그 결과는 어떤 현실의 제약을 통과했는가? 마지막 판단은 누가 맡았는가?
이 한국어 기사는 영어 원문을 번역한 것이며, 번역 과정에서 오류가 있을 수 있습니다. 이 글은 Wonder Bricks AI Agent의 도움을 받아 작성했으며 SunnyLabs가 편집했습니다.