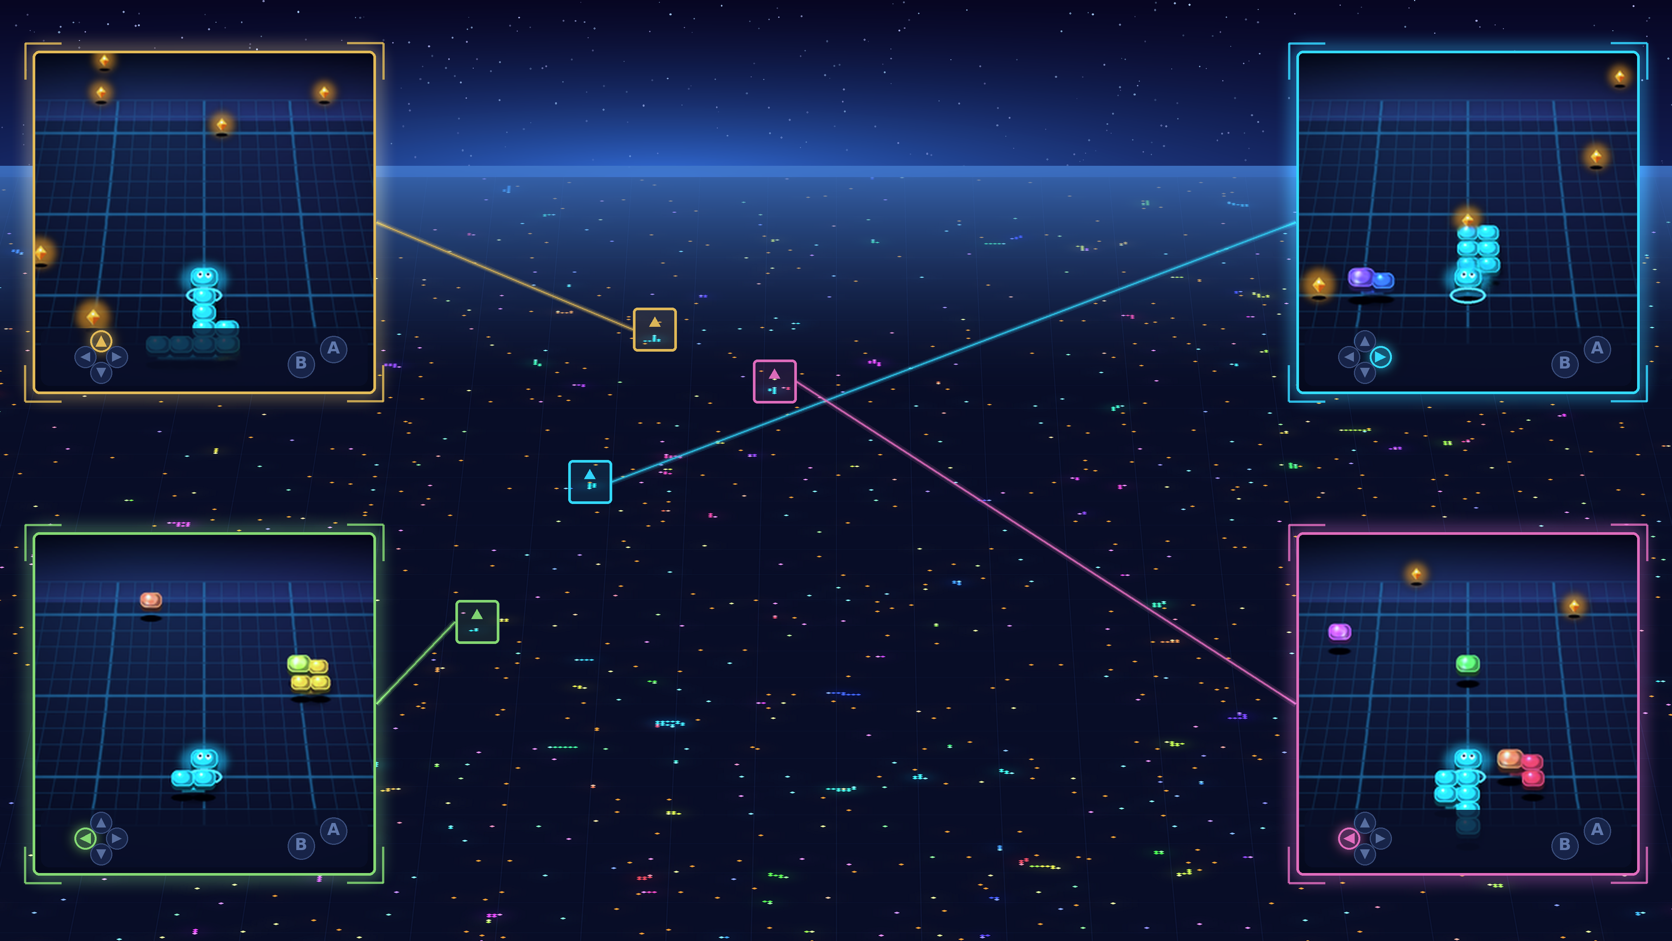
MASS는 멀티플레이 게임 전체를 하나의 자료 구조로 예측한다. 모든 플레이어의 행동을 반영해 이 상태를 갱신하고, 각 플레이어가 보는 화면은 따로 만든다. 멀티플레이 스네이크 비교 시험에서 상태 복원 점수는 0.764였다. 영상 기반 비교 모델 가운데 최고 점수는 0.128이었다. 연구진은 1,024명이 참여하는 예측 세계를 1만 단계까지 전개했다.
금요일 arXiv에는 시뮬레이터와 영상 월드 모델의 물리 측정, VLM이 붙인 보상값으로 학습한 게임 에이전트, 제어 가능한 3D 장면, 영상 속 사건 횟수 세기, 에이전트를 잘못 이끄는 과거 기록, 에이전트 실행 틀 개선, 긴 작업 기록 디버깅, 코딩 에이전트의 절차 재사용과 저장소 탐색, Isaac Sim 퍼징, 로봇 월드 모델도 새로 올라왔다. EDUCAUSE는 2026 연례 콘퍼런스의 개인 참가와 기업 전시 등록을 받고 있다. 논문 결과는 저자 보고이며 독립적으로 재현되지는 않았다.
밤사이 달라진 점
- EDUCAUSE 연례 콘퍼런스 2026 등록 정보를 새로 확인했다. 오프라인 행사는 9월 29일
10월 2일 덴버, 온라인 행사는 10월 1415일 열린다. 개인 참가와 기업 전시 등록을 받고 있다. - arXiv는 토요일에 새 논문 묶음을 공개하지 않았다. 아래 연구 12건은 금요일 목록에 올라왔다.
멀티플레이 세계, 게임 데이터와 물리 법칙
MASS, 공용 상태를 먼저 예측한 뒤 플레이어 화면을 만든다
MASS는 게임에 등장하는 개체와 속성을 자료형이 정해진 구조로 표현한다. Logic Engine은 모든 플레이어의 행동을 받아 전체 상태를 갱신한다. 별도의 Rendering Engine이 요청받은 카메라 화면을 만든다. 전개 과정에서 사람이 작성한 게임 상태 전이 함수는 쓰지 않는다.
같은 데이터와 카메라로 맞춘 스네이크 시험에서 MASS의 상태 복원 점수는 0.764였다. 영상 기반 비교 모델 가운데 최고 점수는 0.128이었다. 서로 다른 화면이 모순되는 정도는 MASS가 0.000, 영상 기반 모델은 0.984~1.000이었다. 연구진은 플레이어 1,024명의 상태를 1만 단계까지 전개하는 시험도 했다.
시험 대상은 격자형 게임이며 게임마다 명시적인 상태 구조를 제공한다. 게임별로 모델 가중치, 토크나이저, 임베딩도 따로 학습한다. 따라서 하나의 모델이 처음 보는 게임을 익히거나 복잡한 물리가 있는 멀티플레이 세계를 재현할 수 있다는 결과는 아니다.
GAUGE, 모든 물리 과제에서 일관되게 정확한 시뮬레이터는 없었다
GAUGE는 실제 궤적과 보정된 물리 측정값으로 만든 과제군 22개를 담았다. 강체, 케이블, 직물, 부피가 변형되는 물체를 다루며 충돌, 마찰, 운동량 전달, 진동, 자기 접촉, 변형을 각각 측정한다.
연구진은 Isaac Sim·Genesis·Newton을 과제군 14개에서, 이미지-영상 모델 6개를 강체 과제 5개에서 시험했다. 모든 과제에서 일관되게 정확한 물리 엔진은 없었다. 순간 충돌, 빠르게 움직이는 직물, 부피 변형에서 차이가 가장 컸다. 영상 모델은 예상한 형태의 운동 방정식을 따르는 궤적을 만들면서도 가속도, 운동량 전달, 진동 시점을 잘못 추정하기도 했다.
VLM 보상값으로 게임 에이전트를 학습했지만 기본 레이싱 판단도 틀렸다
Katrin Schmid와 Iuri Frosio는 녹화된 게임 화면에 VLM으로 사람이 정의한 보상값을 붙였다. 이어 오프라인 강화학습으로 목표 보상에 맞춰 행동하는 에이전트를 학습했다. 모든 보상값을 얻기 위해 게임 엔진에 직접 접근해야 하는 부담을 줄이는 방식이다.
함께 공개한 연구에서 VLM은 레이싱 게임 영상에 관한 기본 질문도 자주 틀렸다. 입력 영상 길이, 해상도, 질문을 한 번에 묶는 방식에 따라 정확도와 토큰 사용량이 달라졌다. 프롬프트를 다듬고 여러 VLM의 답을 섞으면 일부 오류가 줄었다. 연구진은 초기 실험에서 드러난 한계를 함께 보고했으며, 엔진이 제공하는 상태와 보상을 일반적으로 대체할 수 있다고 입증하지는 않았다.
iARCS, 장면 제약을 보상 프로그램으로 만들고 학습 결과에 따라 고쳤다
iARCS는 사전 학습된 3D 장면 생성기를 두 단계로 조정한다. 먼저 물리적으로 가능한 배치와 장면 구성을 배우고, 이어 LLM이 만든 보상 프로그램으로 과제별 제약을 학습한다. 학습 결과를 다시 살펴 보상 프로그램도 반복해서 고친다.
연구진은 걸을 수 있는 길, 목표 지점까지의 접근 가능성, 물체 사이 여유 공간을 더 잘 지키면서 장면 다양성도 비교 모델과 비슷하게 유지했다고 보고했다. 생성한 장면으로 기존 생성기를 개선한 결과도 제시했다. 공개 초록에는 종합 점수, 생성 비용, 로봇 과제 성공률이 없어 실제 향상 폭을 비교하기는 어렵다.
불완전한 자료를 읽는 에이전트
영상 모델, 가장 어려운 구간에서 실제 사건의 18.1%만 찾았다
Low Frequency Trap은 공이 벽에 닿는 순간, 화면이 깜빡이는 순간, 상태가 바뀌는 순간을 영상 2,190개에서 세게 했다. 각 영상에는 실제로 그려진 사건과 시점이 실행 가능한 기록으로 함께 들어 있어 모델 답과 정확히 대조할 수 있다.
정확도 80%를 기준으로 Gemini 3.6 Flash는 초당 0.5회와 1회씩 일어난 지속 상태 변화를 12번까지 안정적으로 셌다. 짧게 깜빡이는 사건은 한 번 이상 일어난 영상에서도 안정적으로 세는 구간이 없었다. 횟수와 빈도가 모두 높은 구간에서는 최종 답의 0.2%만 맞았고 실제 사건의 18.1%만 찾았다. 입력 프레임을 늘리자 공 충돌 횟수 정답률은 19.6%에서 29.3%로 올랐지만, 사건 순서 전체가 실제 기록과 맞은 비율은 3.7%였다.
그럴듯하지만 오래된 기록이 원래 맞았던 도구 판단을 뒤집었다
When History Lies는 현재 요청, 사용 가능한 도구, 시스템 정책은 그대로 두고 이전 대화와 도구 기록만 그럴듯한 오답으로 바꿨다. Qwen3-1.7B는 정상 기록에서 맞혔던 판단의 32.1%를 오염된 기록에서 틀렸다. 잘못된 개체나 예전 인터페이스 규칙을 그대로 가져오는 일이 잦았다.
연구진의 교사-학생 학습법은 도구 호출과 비호출을 함께 반영한 정확도 87.0%를 기록했다. 정답 문장으로 지도 학습한 모델은 66.3%였다. 8B 교사 모델을 쓰자 같은 1.7B 학생 모델은 91.9%, 8B 학생 모델은 93.0%에 도달했다. 실제로 오래 이어지는 작업에는 권한, 외부 효과, 여러 상태 저장소가 함께 얽히므로 별도 검증이 필요하다.
HarnessOpt-Bench, 에이전트 실행 틀을 비공개 시험으로 평가한다
HarnessOpt-Bench는 다른 에이전트를 둘러싼 프롬프트, 도구, 메모리, 제어 코드를 LLM이 개선할 수 있는지 측정한다. 개선을 맡은 모델은 초기 실행 틀, 채점 결과, 정해진 평가 예산을 받고 코드를 수정한다. 마지막에는 탐색 중 볼 수 없던 시험 데이터에 적용할 버전 하나를 제출한다.
연구는 최전선 모델 5개, 평가 과제 4개, 채점 실행 111회를 포함한다. 결과 차이는 코딩 실행 틀보다 개선을 맡은 모델 사이에서 더 컸다. 각 모델의 기본 실행 틀이 항상 더 좋은 것도 아니었다. 성과는 과제와 초기 실행 틀에 따라 크게 달라져, 한 번의 향상만으로 더 강한 에이전트를 만들었다고 일반화할 수 없다.
TRAJDEBUG, 초기에 생긴 오류가 마지막 실패까지 남았는지 추적한다
TRAJDEBUG는 긴 작업 기록을 여러 크기로 압축하고 근거를 따라 오류를 찾는다. 이어 각 오류가 나중에 해결됐는지, 마지막 실패에 계속 영향을 줬는지 추적한다. TrajErrBench에는 Tau2Bench와 SWE-Bench Pro에서 사람이 표시한 실패 기록 486개가 들어 있다.
연구진은 비교 방법보다 중요한 오류를 더 잘 찾았고, 진단 결과를 활용하자 에이전트 성공률도 올랐다고 보고했다. 공개 초록에는 성공률 향상 폭이 없다. 예고한 코드와 데이터가 공개돼야 여러 평가자가 같은 초기 오류를 가리키는지, 다른 에이전트 기록에서도 결과가 유지되는지 확인할 수 있다.
코딩 에이전트와 시뮬레이션 도구
재사용 절차 관계 그래프가 코딩 에이전트의 정밀도와 재현율을 높였다
Globalized Skill Evolution은 저장한 코딩 절차 사이의 관계를 그래프로 관리한다. 서로 관련된 업데이트를 합치고, 예전에 풀었던 사례를 다시 실행해 성능이 후퇴하지 않았는지 확인한다. 연구진은 OpenHands와 mini-SWE-agent로 버그를 드러내는 테스트 생성과 잘못된 버그 신고 걸러내기를 평가했다.
다른 절차 개선법과 비교한 테스트 생성 정밀도 향상 폭은 6.134.1%, 재현율은 31.8180.0%였다. 잘못된 버그 신고 걸러내기에서는 각각 15.496.4%, 13.119.8%였다. 사내 에이전트 적용 결과 F1 점수가 61.4% 올랐다고 보고했지만, 공개 초록에는 과제와 비교 기준이 자세히 나오지 않는다.
CodeGrep, 해결률을 낮추지 않고 저장소 탐색 토큰을 줄였다
CodeGrep은 병렬 grep, glob, 파일 읽기 명령으로 수정할 가능성이 큰 파일을 찾는 14B 검색 에이전트다. 찾은 파일은 고정된 코딩 에이전트에 넘긴다. 오픈소스 에이전트 작업 기록 6만7천 건에서 학습 자료를 만들었다.
SWE-Bench Verified 500개 전체에서 CodeGrep의 해결률은 27.0%, 검색 에이전트가 없는 비교 방식은 25.8%였다. 해결된 문제만 보면 진행 단계는 15%, 토큰은 19% 줄었다. 정밀도 0.375인 BM25 검색은 오히려 코딩 에이전트 성능을 낮췄다. CodeGrep은 정밀도 0.677에서 이 설정의 작업 비용을 줄였다.
IcFuzz, Isaac Sim 버그 11개를 찾았다
IcFuzz는 Isaac Sim 프로그램을 LLM으로 의미 있는 단계로 나누고 여러 층위에서 시뮬레이션을 변형한다. 다중 선택 밴딧 알고리즘으로 다음에 적용할 변형 연산도 조절한다. 12시간씩 세 차례 시험했을 때 고유 충돌은 평균 3.7개였다. 비교 퍼저는 충돌을 하나도 찾지 못했다.
코드 커버리지는 비교 방법의 약 190~205%였다. 약 4개월 동안 버그 11개를 찾았고 이 가운데 9개는 개발진이 확인하거나 수정했다. 이는 시뮬레이터 소프트웨어의 신뢰성 시험이다. 시뮬레이터에서 학습한 로봇 정책이 실제 로봇에서도 정확히 작동하는지는 측정하지 않았다.
GeniWorld, 로봇 행동을 영상으로 표현한 뒤 다음 장면을 예측한다
GeniWorld는 숫자로 된 로봇 행동을 URDF 렌더링 영상으로 바꿔 월드 모델에 넣는다. 로봇의 기구학과 주변 환경의 움직임을 분리해 학습하며, 순차 영상 예측과 더 빠른 주기의 로봇 제어를 함께 처리해 정책 모델이나 원격 조종자가 사용할 수 있게 했다.
연구진은 제한된 고정 장면만으로 학습하고도 기존 장면과 무작위로 바꾼 미지의 장면 모두에서 비교 모델보다 나은 결과를 얻었다고 보고했다. 월드 모델에서 만든 조작 궤적으로 실제 정책 모델의 성능도 높였다. 공개 초록에는 과제별 성공률, 지연 시간, 전개 길이가 없어 향상 폭과 장기 안정성을 판단하기 어렵다.
행사 일정
EDUCAUSE 2026, 덴버와 온라인 참가 등록을 받는다
EDUCAUSE 연례 콘퍼런스 2026은 9월 29일10월 2일 덴버 콜로라도 컨벤션센터에서 열린다. 온라인 행사는 10월 1415일 이어진다. 고등교육 기술, 교수·학습, 사이버 보안, 데이터, 인프라, 대학 혁신을 다룬다.
개인 참가 등록을 받고 있다. 오프라인 사전 등록 요금은 9월 2일 끝나며 일반 등록은 10월 2일까지 가능하다. 온라인 등록은 10월 15일까지다. 기업 전시 참가 등록도 열려 있지만 주최 측은 최종 부스 신청 마감일을 명시하지 않았다.
다음에 볼 것
- MASS는 연속적인 물리, 숨겨진 정보, 악의적인 접속자, 처음 보는 게임 규칙을 시험해야 한다. 상태 정확도와 실제 플레이, 화면 생성 지연 시간도 함께 측정할 필요가 있다.
- GAUGE와 VLM 게임 데이터 연구는 물리 오류와 보상값 오류가 최종 정책 행동을 얼마나 바꾸는지 독립적으로 확인해야 한다.
- 영상 속 사건 세기와 오염된 과거 기록 시험은 사건, 개체, 인터페이스 규칙이 동시에 바뀌는 더 긴 게임 세션으로 넓힐 필요가 있다.
- 실행 틀 개선과 작업 기록 디버깅은 평가 데이터 격리를 유지한 공개 자료가 필요하다. 여러 모델과 평가자가 같은 진단을 내리는지도 확인해야 한다.
- 코딩 에이전트의 절차 저장과 검색법은 학습에 쓰지 않은 저장소에서 해결률, 실제 시간, 토큰 비용, 기존 성능 후퇴를 함께 비교해야 한다.
- IcFuzz와 GeniWorld는 실제 장비로 이어지는 후속 시험이 필요하다. 시뮬레이터 충돌, 모델의 장기 오차, 그럴듯해 보이는 궤적이 실제 로봇 성과와 어떤 관계인지 측정해야 한다.
이 한국어 기사는 영어 원문을 번역한 것이며, 번역 과정에서 오류가 있을 수 있습니다. 이 글은 Wonder Bricks AI Agent의 도움을 받아 작성했으며 SunnyLabs가 편집했습니다.