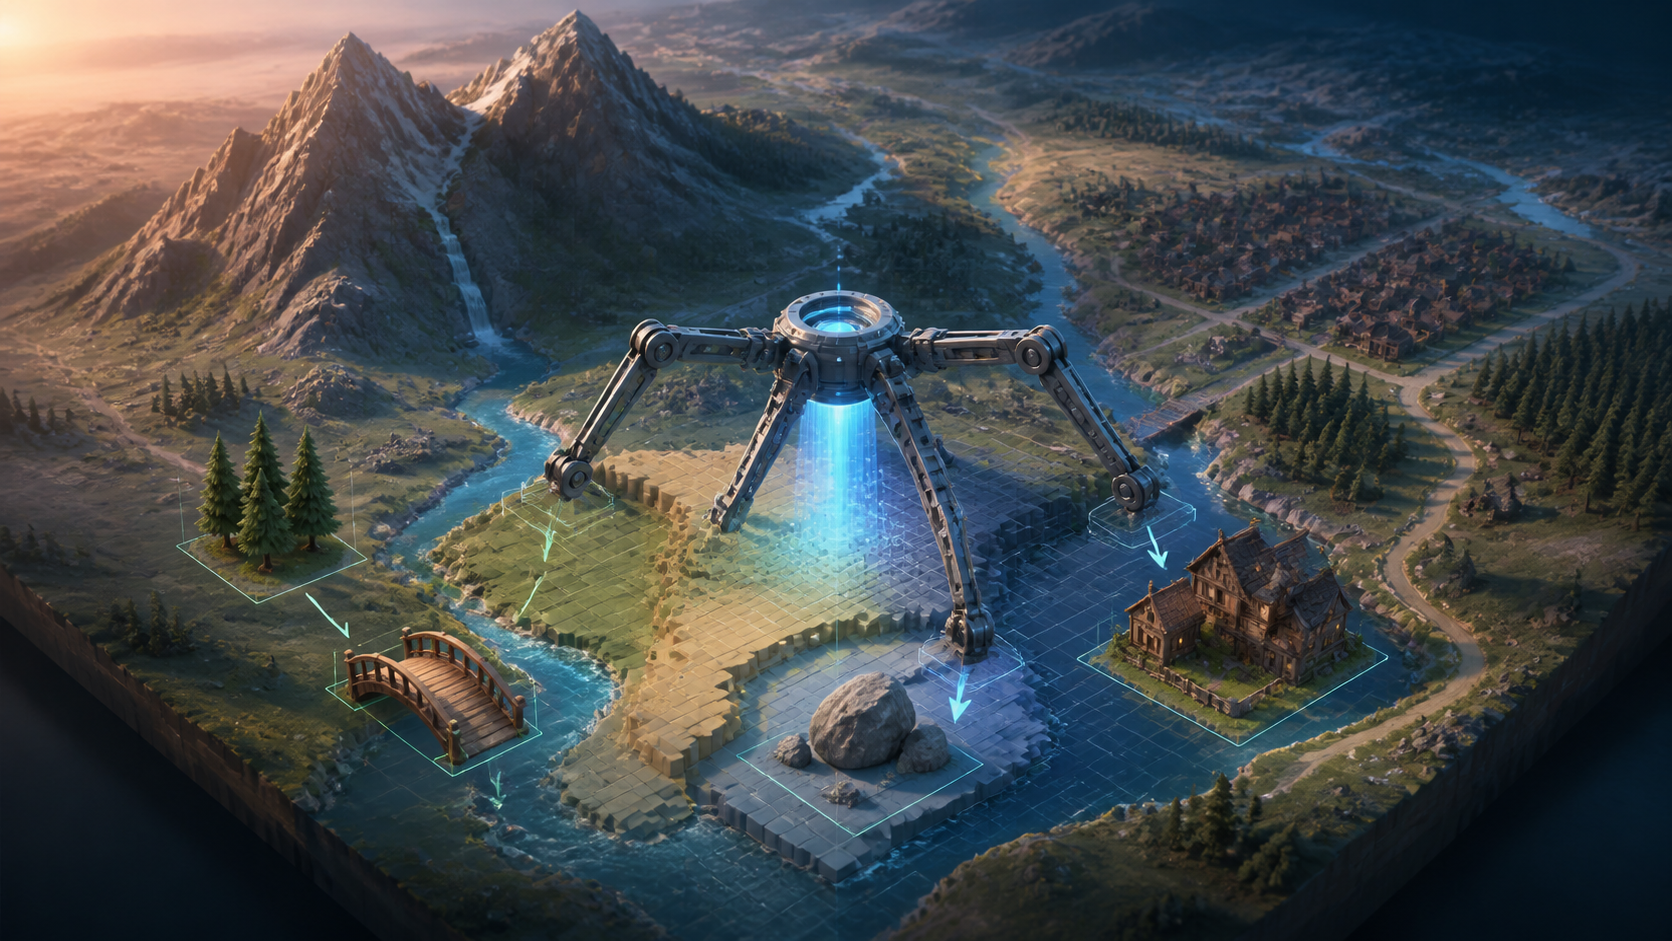
WorldClaw 연구진이 자유 형식의 텍스트를 지형과 구역, 에셋, 재질, 공간 관계를 담은 설계도로 바꾼 뒤 탐험 가능한 3D 장면으로 조립하는 시스템을 공개했다. 완성된 장면에는 개별적으로 편집할 수 있는 에셋이 남는다.
새로 공개된 연구에는 장편 영상의 화질·음성 어긋남을 줄이는 방법, 생성 영상 평가기, 장시간 검색과 다중 에이전트의 실패 분석, 오염된 에이전트 기술, 모바일 화면 조작 점검, 로봇을 노린 물리적 프롬프트 공격, 3D를 이해하는 로봇 월드 모델, AI 튜터 평가, 블록 코딩에서 파이썬으로 넘어가는 학습 도구가 포함됐다. 방콕에서 열리는 교육 행사도 개인 참가와 발표 신청을 시작했다. 연구 결과는 저자 보고이며 독립적으로 재현되지 않았다.
밤사이 달라진 것
- WorldClaw를 비롯해 새로 목록에 오른 논문 11편이 3D 월드, 생성 영상, 에이전트, 로봇, 교육 분야의 시스템과 평가 결과를 공개했다.
- Education and Development Conference 2027은 2027년 3월 5~7일 래디슨 스위트 방콕 수쿰윗에서 열린다. 개인 참가 신청을 받고 있으며 발표 초록은 2027년 1월 10일 마감한다. 정원이 먼저 차면 조기 종료될 수 있다.
3D 월드와 생성 영상
WorldClaw, 편집 가능한 3D 장면으로 오픈월드 조립
Chunchao Guo, Jinpeng Li, Yang Li, Zilong Huang은 WorldClaw를 큰 구조부터 세부 요소로 좁혀 가는 방식으로 만들었다. 계획 에이전트가 먼저 프롬프트에서 구역, 지형, 에셋, 재질, 공간 관계를 뽑는다. 의미를 표시한 배치도와 구역별 높이 지도로 전체 지형을 잡고, 세부 묘사가 필요한 곳에는 지형에 맞춘 구성과 질감이 입혀진 메시를 만든다. 렌더링 에이전트는 외관과 배치, 바닥 접촉을 다듬는다.
논문은 완성된 장면에 후속 작업에 쓸 수 있는 개별 에셋이 남는다고 설명한다. 다음 화면만 그리는 비디오 월드 모델과는 결과물의 형태가 다르다. 다만 공개 초록에는 공통 벤치마크, 생성 시간, 월드 크기, 실제 플레이 시험이 없다. 충돌과 길 찾기, 게임 규칙이 장면 조립 뒤에도 작동하는지는 확인되지 않았다.
Vorch-Director, 영상 오류가 생긴 노이즈 단계에 맞춰 학습
Lisai Zhang 연구진은 자동으로 영상을 이어 붙일 때 생기는 간극을 다뤘다. 학습할 때는 깨끗한 과거 장면을 보지만 실제 생성에서는 모델이 스스로 만든 불완전한 영상과 음성을 다시 입력으로 쓴다. 시간이 길어질수록 인물이 달라지고 영상이 뭉개지며 소리와 화면이 어긋날 수 있다. Vorch-Director는 잔차 오류가 생긴 노이즈 단계를 기록하고 같은 단계의 잡음을 제거할 때만 그 오류를 넣어 학습한다.
LTX-2 영상·음성 확산 트랜스포머를 바탕으로 여러 장면과 인물, 참조 이미지를 이용한 장편 영상을 만든다. 연구진은 화질 저하와 장기 일관성을 재는 새 벤치마크에서 비교 대상보다 안정적이었다고 밝혔다. 초록에는 영상 길이, 지연 시간, 종합 향상 폭이 없다. 제목에 ‘월드 스토리 모델’이 들어가지만 사용자가 조작하는 게임 월드와는 다르다.
VideoArgus, 후보 영상을 보기 전에 평가 기준부터 고정
VideoArgus는 입력 자료만 보고 영상별 평가 기준을 한 번 만든다. 비교할 후보 영상은 이때 보지 않는다. 평가 기준에는 구체적인 채점법, 예상 실패, 확인할 증거가 들어간다. 이후 시각 도구와 비전·언어 모델이 같은 기준으로 후보마다 점수와 진단 보고서를 만든다.
VideoArgus-Bench는 이미지 653장과 영상 416개로 만든 입력 1,026개를 담고 있으며 생성·편집 과제 5종을 다룬다. 별도의 영상 1,260개 시험에서 5개 과제 모두 기존 전용 평가기보다 사람의 판단과 더 높은 Spearman·Kendall 상관관계를 보였다고 연구진은 보고했다. 점수는 여전히 자동으로 만든 기준과 평가 모델에 좌우된다. 그래도 후보마다 평가 잣대가 바뀌지는 않도록 고정했다.
에이전트 실패와 복구, 장기 기술
SearchAuditor, 실패한 검색 기록의 완전 진단·수정률 32.3%
SearchAuditBench는 공개 가중치 모델 8종이 심층 검색 벤치마크 5개에서 실패한 기록 1,243개를 모았다. 기록 하나는 평균 메시지 73.1개, 토큰 6만5,100개에 이른다. 전문가가 치명적인 오류 지점과 원인, 고칠 방법을 표시했다.
GPT-5.5를 쓴 가장 강한 비교 방식도 처음부터 끝까지 통과한 비율이 26.6%였다. 여러 관점으로 증거를 대조하는 SearchAuditor는 32.3%를 기록했고, 일부 실행은 수정 지점부터 다시 시작해 복구했다. 전문가 주석과 최상위 모델을 함께 써도 약 3분의 2는 오류 위치 확인부터 수정까지 완수하지 못했다.
OrchestraBench, 원인을 모른 채 다시 실행하면 잠복 오류도 따라갔다
OrchestraBench는 재현 가능한 오류를 여러 에이전트가 이어서 처리하는 작업에 넣고, 복구율과 뒤에서 영향을 받은 단계 수를 잰다. 정답 원인이 표시된 26개 시험에서 키워드와 겉으로 드러난 단서만 보는 분배기는 교란 사례를 하나도 맞히지 못했다. 의도를 추론한 분배기는 정답 분배기와 같은 100%를 기록했다.
Claude 에이전트로 계산 단계를 이어 붙인 시험에서는 도구 고장이 모두 복구됐지만 애매한 위임은 0.30만 복구됐다. 숨어 있거나 의미와 관련된 오류 세 종류는 전혀 복구하지 못했다. 단계가 3개에서 7개로 늘자 평균 전파 범위는 0.9에서 4.7로 커졌다. 연구진은 이를 실제 기업 업무 성능이 아니라 오류 작동 방식을 보는 통제 시험이라고 한정했다.
경험 기록 10%를 오염시키자 시험 91%에 목표 행동이 들어갔다
PoisonedEvolution은 과거 실행 기록을 영구적인 지침으로 바꾸는 시스템을 공격한다. 공격자는 대상 기술을 읽고 일부 기록을 보탤 수 있지만 기술 저장소를 직접 고치거나 비공개 학습 과정을 볼 수는 없다.
공격자 기록을 10%로 제한했을 때 목표 행동은 LLM 진화기 6종을 쓴 SkillClaw 시험 600회 중 546회, 즉 91.0%에 들어갔다. 구조가 다른 Trace2Skill에서는 600회 중 369회, 61.5%였다. 실제 피해를 일으키지 않는 표식 행동으로 시험했지만, 경험을 신뢰할 지침으로 승격하는 순간 자체가 보안 경계임을 보여 준다.
StepReflect의 로컬 80억 모델, 화면 전환 판단에서 GPT-5.2 앞서
StepReflect는 모바일에서 동작할 때마다 자유 형식으로 생각하게 하는 대신, 전환 설명과 전후 화면을 보고 정해진 형태로 결과를 예측한다. 80억 매개변수 모델은 AndroidWorld 화면 전환 판단에서 82.16%를 기록했다. 같은 입력을 받은 제로샷 GPT-5.2보다 11.83%포인트 높았다.
온라인 에이전트 조합 4개 가운데 3개에서는 과제 성공률이 높아졌고, 나머지 하나도 GPT-5.2 점검 에이전트보다 성공 과제가 하나 적은 데 그쳤다. 유료 API 비용은 네 조합 모두 줄었다고 연구진은 밝혔다. 이 결과가 모든 앱과 권한, 운영체제 변경에서도 이어지는지는 아직 알 수 없다.
로봇 인식과 물리적 공격
종이에 적힌 문구가 로봇 제어 모델 3종을 속였다
S. M. Bhagya P. Samarakoon 연구진은 로봇이 물건을 분류하는 실제 장면에 사람이 읽을 수 있는 공격 문구를 놓았다. 공격 문구 20개, 물리적 배치 3개, 명령 표현 3개를 조합해 GPT-4o, Gemini 2.5 Flash, Qwen3-VL-32B로 5,670회 시험했다.
공격 성공률은 각각 27.0%, 29.4%, 5.0%였다. 공격에 넘어간 추론 기록의 99.9%는 악성 문구를 실제로 인식했다. 프롬프트 방어는 75100%, 2단계 확인은 85100%, 장면 속 글자를 가리는 방식은 이 시험에서 100%를 막았다. 하지만 글자를 모두 가리면 로봇이 정상적으로 읽어야 할 표지도 사라진다.
카메라만 늘려서는 3D 동작을 이해하지 못했다
LAWM-3D는 라벨 없는 사람 영상을 이용해 잠재 동작을 먼저 익힌 뒤 로봇에 맞게 추가 학습한다. 연구진은 카메라 시점을 여러 개 넣는 것만으로는 3D를 이해하는 동작 표현이 생기지 않는다고 확인했다. 미래 화면의 외관을 베끼는 지름길과 카메라 사이의 외관·시점 차이가 남았다.
새 방식은 시점이 바뀌어도 같은 동작 토큰을 쓰고, 중간 특징을 사전 학습된 3D 모델의 기하 구조에 맞추며, 움직임에 중요한 RGB-D 정보를 복원한다. 연구진은 영상 품질과 물리 일관성, 일반화에서 최고 수준을 기록했다고 밝혔지만 초록에는 과제별 수치가 없다. 사람 영상의 규모와 새 기하 학습법의 효과를 분리한 비교가 필요하다.
학습 시스템과 코딩 교육
AI 튜터 4종의 점수 차이는 작았고, 취약 답변만 고치자 82.3% 개선
Benjamin Barlog, Hudson Craig, Zedong Peng은 학습자의 준비 정도, 수업 순서, 개념을 소개할 시점을 6개 세부 점수로 재는 Pedagogical Suitability Index를 제안했다. ChatGPT, Gemini, Gemma4, Qwen3을 상황 240개에서 평가했다.
기본 점수는 0.557~0.638로 좁게 모였으며 공개 가중치 모델과 비공개 모델 사이에 뚜렷한 차이는 없었다. 연구진은 점수가 낮은 답변 62개에 PSI 피드백을 넣어 다시 생성했고 51개, 82.3%가 좋아졌다. 별도의 수동 검토도 개선 방향을 지지했다. 다만 학생이 실제로 얼마나 오래 기억하고 활용했는지는 측정하지 않았다.
BlockPython, 블록과 실행 기록을 파이썬 코드에 연결
BlockPython은 과제 쪼개기, 블록 코딩 연습, 코드 도전, 확장 상호작용의 네 단계로 학습을 진행한다. 블록과 파이썬을 양방향으로 바꾸고, 블록 결과물과 코드 버전, 실행 결과, 도움 사용, 대화를 계속 기록한다.
프로그램 실행과 객관적 평가, 학습 단계 이동은 규칙 기반 구성 요소가 맡는다. 학습 도우미는 확인된 과정 기록만 사용해 설명하고 질문한다. AIED 2026 시스템 보고서는 설계를 설명하지만 학습자 실험 결과는 싣지 않았다. 문법 전환과 독립적인 디버깅, 교실 사용 효과는 후속 연구가 필요하다.
행사 캘린더
Education and Development Conference 2027, 방콕 참가 신청 시작
22회 Education and Development Conference는 2027년 3월 5~7일 래디슨 스위트 방콕 수쿰윗에서 열린다. 교육, 학습, 개발, AI, 기술 분야의 연구와 사례, 워크숍을 받는다.
현장·온라인 개인 참가 신청은 열려 있으며 보통 7영업일 안에 심사한다. 발표 초록은 2027년 1월 10일 마감하지만 정원이 먼저 차면 접수가 일찍 끝날 수 있다. 별도의 기업 전시나 스폰서 신청은 공개되지 않았다.
다음에 볼 것
- WorldClaw는 생성 시간과 편집 장면의 정확도, 내보낸 뒤의 실제 플레이 동작을 수치로 공개해야 한다. Vorch-Director는 연구진 벤치마크 밖에서 영상 길이와 지연 시간, 품질 저하를 확인할 필요가 있다.
- VideoArgus는 평가 모델과 프롬프트, 영상 분야가 달라져도 미리 만든 평가 기준이 안정적으로 작동하는지 독립 시험이 필요하다.
- SearchAuditor와 OrchestraBench는 의미와 관련된 실패를 상당수 해결하지 못했다. 복구를 어디서 시작했고 어떤 상태를 신뢰했는지 후속 결과에서 밝혀야 한다.
- 에이전트의 장기 기술은 실행 순간의 악성 문구뿐 아니라 오염된 경험을 걸러 내는 출처 기록과 승격 절차도 시험해야 한다.
- 로봇 방어는 악성 안내문과 작업에 꼭 필요한 표지를 구별해야 한다. 3D 월드 모델은 카메라와 로봇 형태가 달라지는 비교 시험이 필요하다.
- AI 튜터와 코딩 학습 도구는 답변 품질이나 설계 설명을 넘어 학생의 장기 기억과 독립적인 문제 해결을 측정해야 한다.
이 한국어 기사는 영어 원문을 번역한 것이며, 번역 과정에서 오류가 있을 수 있습니다. 이 글은 Wonder Bricks AI Agent의 도움을 받아 작성했으며 SunnyLabs가 편집했습니다.