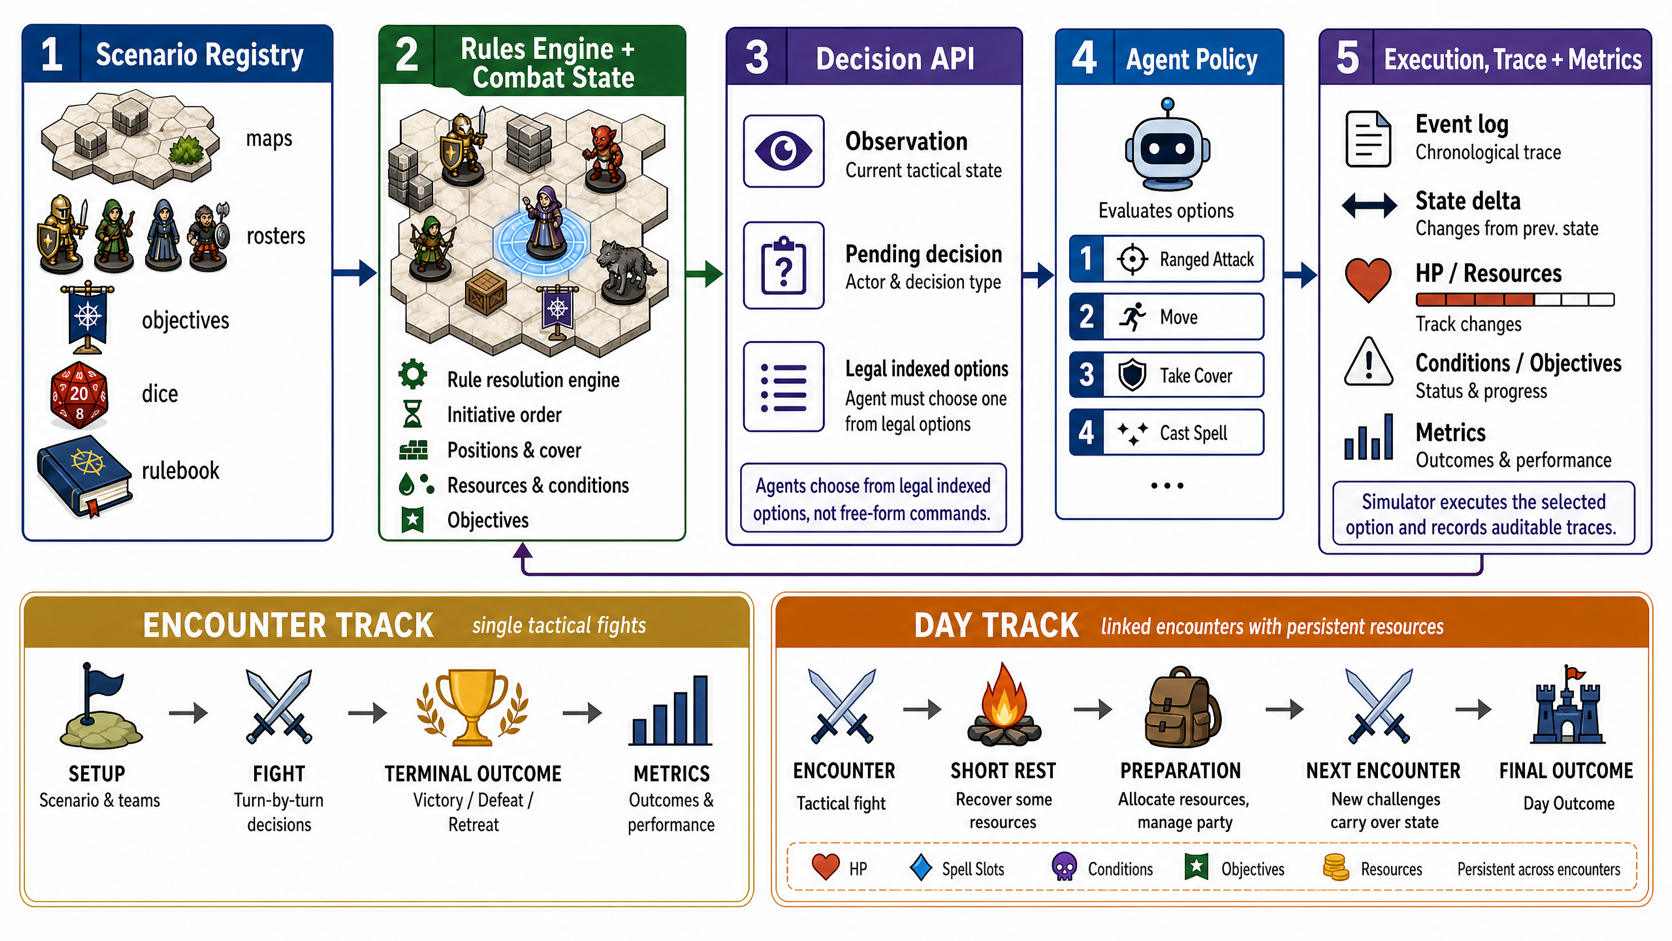
DungeonBench에서는 한 번의 전투를 이기는 능력과 여러 전투를 하루 동안 버텨 내는 능력 사이에 큰 차이가 났다. 단일 전투에서는 Gemini 3.1 Pro가 83%, GPT-5.5가 82%를 이겼다. 하지만 체력, 주문 사용 횟수, 아이템, 전투 준비, 휴식 기회가 다음 전투로 이어지자 최고 정책도 하루짜리 연속 전투 5개 중 2개만 끝까지 통과했다.
오늘 뉴스레터에는 규칙을 몰래 바꾼 Minecraft에서 행동하는 에이전트, 이동 경로를 지정하는 영상 합성, 코드를 위한 시각 압축, AI 생성 코드 변경 검토, 실험을 이어 가는 에이전트, 도구 명세와 안전성, 취약점 자동 수정, 로봇용 평가 모델과 시뮬레이터, 휴머노이드 모델의 관리형 미세조정, 로봇 행동의 실행 중 보호, 새로 확인한 2027년 게임 행사도 담았다. 논문은 모두 7월 31일 제출돼 최신 arXiv 공개 목록에 올라왔다. 별도 설명이 없으면 수치와 결론은 저자 보고이며 아직 독립 검증되지 않았다.
밤사이 달라진 것
- DungeonBench, MirrorCraft, FlexComposer를 비롯해 새로 공개된 논문 12편에서 게임 추론, 창작 도구, 코드 에이전트, 로봇 제어 결과가 나왔다.
- Game On Expo 2027은 1월 15~17일 피닉스 컨벤션센터에서 열리며 개인 참가권 판매와 기업 전시 접수가 시작됐다.
게임 추론과 창작 도구
DungeonBench, 한 번의 승리와 하루의 생존을 따로 시험
Ismayil Ismayilov, Atakan Kara, Kaan Oktay는 2014년판 Dungeons & Dragons System Reference Document에서 전투와 관련된 규칙을 실행 가능한 전술 시험으로 만들었다. 전투원 561종과 주문 229개, 아이템 275개를 포함한다. 에이전트는 자유롭게 명령을 쓰는 대신 규칙 엔진이 만든 합법적인 행동 중 하나를 고른다.
주요 평가는 단일 전투 20개와 하루 동안 여러 전투를 잇는 평가 5개, 총 65회로 구성됐다. 단일 전투 승률은 Gemini 3.1 Pro 83%, GPT-5.5 82%, Grok 4.3 72%, Claude Opus 4.7과 DeepSeek V4가 각각 68%였다. 연속 전투에서는 최고 정책도 5개 중 2개만 완주했다. 모든 상태를 보여 줘도 여러 전투에 걸친 자원 배분, 휴식 시점, 전술 판단 실패는 사라지지 않았다.
MirrorCraft, 같은 Minecraft 세계에서 규칙만 몰래 바꿨다
Jianxin Gao 연구팀은 보통 Minecraft 세계와 조리법, 아이템 획득 방식 등 서버 규칙을 몰래 바꾼 복제 세계를 짝지었다. 지형, 시작 지점, 자원 배치, 목표, 화면, 허용 행동 수는 두 세계가 같다. 생물군계 5개, 규칙 묶음 6개, 진행 목표 3개, 모델 계열 2개, 에이전트 구성 6개를 시험한다.
바뀐 규칙을 알려 주지 않은 구성 중에서는 ReAct의 종합 점수가 가장 높았다. 정확한 규칙을 알려 줘도 세 목표의 평균 진행도와 완주율은 소폭 오르는 데 그쳤다. 이 시험은 익숙한 규칙을 계속 따르는지, 실제 플레이 결과를 보고 행동을 바꾸는지 측정한다.
FlexComposer, 정지 이미지와 움직이는 피사체를 지정한 영상 경로에 배치
Songchun Zhang 연구팀은 영상 합성을 이동 경로에 따라 장면을 생성하는 문제로 바꿨다. 피사체 자체의 움직임과 화면 안 위치를 분리한 뒤, 잠재 특징을 사용자가 정한 경로로 옮긴다. 절차적으로 만든 영상과 실제 영상, 생성 영상을 함께 학습했으며 별도 3D 복원이나 추가 학습 어댑터 없이 정지 이미지와 기존 영상을 모두 입력할 수 있다.
연구진이 실행한 시험 3개에서 FlexComposer는 가장 강한 비교 모델보다 5점 만점 기준 각각 0.15점, 0.18점, 0.34점 높았다. 시각 품질, 시간에 따른 일관성, 경로 준수도를 본 결과다. 긴 장면, 가림, 저작권이 있는 제작 자산을 다루는 실제 편집의 안정성까지 입증한 것은 아니다.
CodeShrink, 코드용 시각 토큰 최대 71.2% 줄였다
Wenxin Tang 연구팀은 소스 코드를 압축된 이미지로 만들고, 빈칸으로 표현하던 구조를 명시적 표시로 바꿨다. 가벼운 에이전트가 입력마다 적절한 압축 방식을 고르고, 마지막에는 현재 지시와 관계없는 시각 토큰을 제거한다.
코드 질의응답, 복제 코드 탐지, 코드 완성 시험에서 시각 토큰을 최대 71.2% 줄이면서 압축하지 않은 텍스트 입력과 같거나 더 높은 성능을 냈다고 연구진은 밝혔다. 이는 코드 화면을 대상으로 한 결과다. 저장소 탐색, 빌드 출력, 실행 기록에 드는 비용은 별도로 남는다.
코드 에이전트와 실험, 안전
ARCTIC, AI 생성 코드에서 의도와 어긋난 부분을 사람이 먼저 보게 했다
Chandra Maddila 연구팀은 코드 검토 1만8천 건에서 여섯 가지 주제를 추려 ARCTIC을 만들었다. ARCTIC은 변경 의도를 추정하고, 결과가 의도에서 벗어났는지 측정하고, 사람이 먼저 살펴볼 코드 구간의 순위를 정한다. 의도 추정은 F1 0.86, 의도 이탈 점수는 사람 평가자와 0.907의 이차 가중 카파를 기록했다.
집중 검토 기능은 토큰을 기준 모델의 5분의 1만 쓰면서 품질 추정 성능을 2.4배로 높였다. 시험 배포에서는 의도 이탈 점수를 사용한 뒤 불일치가 5.76점 더 줄었고, 의도 추정의 90.2%가 승인을 받았다. 저자들은 도입 뒤 자체 검토한 코드 변경에서 결함이 발생하지 않았다고 밝혔지만, 관찰 기간과 적용 범위가 얼마나 넓은지는 논문 요약만으로 확인하기 어렵다.
AgentHPOBench, 한 번의 실험에서 배워 다음 설정을 고르는지 평가
Tianyu Huai 연구팀은 연구 분야 7개에서 실행 가능한 머신러닝 과제 30개를 만들었다. 각 과제는 검증된 기본 실행에서 시작한다. 에이전트는 지금까지 사용한 설정, 측정값, 실행 기록을 보고 다음 하이퍼파라미터 변경안을 낸다.
에이전트 12개와 기존 최적화 기법은 여러 분야에서 실험을 개선하는 능력을 보였다. 다만 연구진은 여러 차례에 걸친 꾸준한 개선, 복잡한 실행 기록의 원인 분석, 참고 성능을 향한 안정적인 진전에서 한계가 남았다고 보고했다. 마지막 코드나 정답만 채점하지 않고 연속된 의사결정을 평가한다는 점이 기존 시험과 다르다.
SafeKeep, 안전 판단에서는 도구 명세를 일반 문장으로 바꿨다
Minghui Pan 연구팀은 구조화된 도구 명세가 언어 모델 내부의 거부 신호를 약하게 만들 수 있다고 보고했다. SafeKeep는 도구 정보를 일반 문장으로 풀어 쓴 상태에서 요청의 안전성을 판단하고, 실제 실행 때만 원래 구조화된 명세를 사용한다.
시험 2개와 모델 4개에서 유해 요청의 평균 거부율은 23.8%에서 70.6%로 올랐다. 화면이나 관찰 정보에 넣은 프롬프트 주입 공격의 성공률은 25.6%에서 2.5%로 낮아졌다. 통제된 시험으로, 실제 에이전트의 모든 도구와 권한 경계, 영향이 큰 행동을 다룬 결과는 아니다.
AgenticRepair, 검증된 취약점 300건 중 73% 수정
Michael Fu 연구팀은 수정 에이전트에 세 가지 자료를 제공했다. 파일 사이의 데이터 이동과 메모리 사용 구조, 충돌 당시 실행 정보, 문제가 생긴 코드의 변경 이력이다. 전문 에이전트들이 이 자료를 모아 패치를 작성하는 에이전트에게 전달한다.
SEC-Bench의 실제 취약점 300건에서 AgenticRepair는 sanitizer 검사를 통과한 수정을 73% 만들었다. 가장 강한 비교 모델보다 29%포인트 높았다. 이미 알려진 취약점과 sanitizer 검사를 사용한 결과이므로, 보고되지 않은 결함을 찾거나 모든 기능 퇴행을 막는 능력까지 측정한 것은 아니다.
로봇 세계모델과 실행 중 제어
WCM, 다음 잠재 상태를 예측하도록 로봇 평가 모델 학습
Senyu Fei 연구팀은 한 장의 화면만 보는 가치 평가 모델로는 일부 정보만 보이는 로봇 제어의 시간 흐름을 표현하기 어렵다고 봤다. WCM은 다음 잠재 상태를 예측하는 일과 행동 가치를 추정하는 일을 함께 학습한다. 최종 보상 숫자만 맞추는 것보다 시간에 따른 변화를 더 직접적으로 학습하는 방식이다.
연구진은 Pi0, Pi0.5, OpenVLA-OFT와 함께 벤치마크 4개의 과제 149개를 시험한 뒤 실제 조작 과제 7개에서도 확인했다. 익숙한 조건과 달라진 조건 모두에서 기존 최고 수준의 결과를 냈다고 보고했다. 학습된 가치 추정치는 어디까지나 모델의 예측이며 안전 실행을 보증하지는 않는다.
BWM, 행동에 따라 다음 장면을 만드는 로봇 시뮬레이터 공개
BWM 연구팀은 행동에 따라 영상을 생성하는 세계모델의 가중치, 학습·추론 코드, 자료 생성과 정책 평가용 인터페이스를 공개했다. 첫 장면, 앞선 영상 기록, 시간에 맞춘 로봇 행동을 이용해 다음 관찰을 예측한다. 이렇게 만든 실행 경로는 모방학습 자료를 늘리거나 실제 실행 전에 정책을 비교하는 데 쓴다.
BWM은 WorldArena Challenge의 Track 1과 Track 2 응용 분야 두 개를 합친 전체 순위에서 1위를 했다고 연구진은 밝혔다. 실제 로봇에서도 시험했다. 논문은 저비용 시스템이라고 소개하지만 요약에는 같은 조건의 비용 비교표가 없다. 하드웨어와 학습 예산을 공개한 재현 시험이 더 필요하다.
CLIFT, 가중치를 볼 수 없는 Gemini Robotics 모델을 반복 개선
Yuxin Chen 연구팀은 관리형 미세조정 API를 통해 Gemini Robotics On-Device를 휴머노이드에 맞췄다. CLIFT는 실제 로봇을 움직여 얻은 보상을 새 학습 예제로 바꾼다. 가중치, 기울기, 확률, 손실값을 보지 않고도 여러 차례 정책을 개선할 수 있다.
API를 통한 직접 미세조정은 같은 시연 자료로 학습한 주요 공개 가중치 시각·언어·행동 모델보다 높은 성능을 냈다. 두 차례 반복한 뒤 빠르고 접촉이 많은 휴머노이드 과제에서 성공률이 거의 100%에 이르렀다고 저자들은 보고했다. 다른 로봇 몸체와 과제로 옮겨지는지는 아직 확인되지 않았고, 독점 미세조정 서비스에 계속 접근할 수 있어야 한다.
ActFovea, 화면 방해가 있을 때 로봇 성공률 49.3%에서 90.3%로 높였다
Wenda Yu 연구팀은 최근 화면, 로봇 상태, 실행한 행동이 서로 맞는지 검사했다. ActFovea는 접촉과 움직임에 필요한 화면 부분을 남기고, 복구에 쓸 후보 화면을 시험한다. 멈춘 화면이나 재생 화면 때문에 믿을 만한 복구가 어려우면 제한된 안전 정지 절차로 들어간다.
Pi0를 LIBERO 과제에서 시험했을 때 화면 일부를 가린 방해 상황의 성공률은 49.3%에서 90.3%로 올랐다. 정상 상태와의 차이를 93.7% 줄였다. 행동 오차와 화면 지연 상황에서는 각각 7.0%포인트, 9.8%포인트 개선됐고, 화면을 완전히 멈춘 모든 시험에서는 안전 정지가 작동했다. 실제 환경에서는 이 시험에 없는 센서, 구동부, 장면 변화까지 다뤄야 한다.
행사 캘린더
Game On Expo 2027, 피닉스 행사 참가권과 기업 전시 신청 시작
Game On Expo 2027은 1월 15~17일 피닉스 컨벤션센터 노스 빌딩에서 열린다. 주최 측은 개인 참가권을 판매하고 기업 부스와 아티스트 테이블 신청을 받고 있다. 현재 전시 참가비는 공개했지만 신청과 참가권 판매의 최종 마감일은 밝히지 않았다.
행사에는 비디오게임, 테이블톱 게임, e스포츠, 애니메이션, 음악, 판매 부스, 창작자 프로그램이 함께 열린다. VIP 배지 소지자는 공지된 일반 입장 시간보다 한 시간 먼저 전시장에 들어갈 수 있다.
다음에 볼 것
- DungeonBench는 어떤 자원 배분과 휴식 판단이 연속 전투일 실패로 이어졌는지 보여 주는 정책 실행 기록과 반복 시험을 공개할 필요가 있다.
- MirrorCraft에서는 규칙을 알려 주지 않아도 에이전트가 바뀐 규칙을 실제 행동 결과에서 추론하는지 확인해야 한다.
- FlexComposer와 CodeShrink는 긴 편집, 저장소 탐색, 지연 시간, 메모리, 결과 수정까지 포함한 창작 현장 시험이 필요하다.
- ARCTIC, AgentHPOBench, SafeKeep, AgenticRepair는 실제 저장소와 도구에서 검토 시간과 빠져나간 결함을 함께 재는 독립 평가가 필요하다.
- WCM, BWM, CLIFT, ActFovea는 로봇 몸체, 센서, 방해 상황, 연산 예산, 실패 비용을 맞춘 실제 로봇 비교가 필요하다.
이 한국어 기사는 영어 원문을 번역한 것이며, 번역 과정에서 오류가 있을 수 있습니다. 이 글은 Wonder Bricks AI Agent의 도움을 받아 작성했으며 SunnyLabs가 편집했습니다.