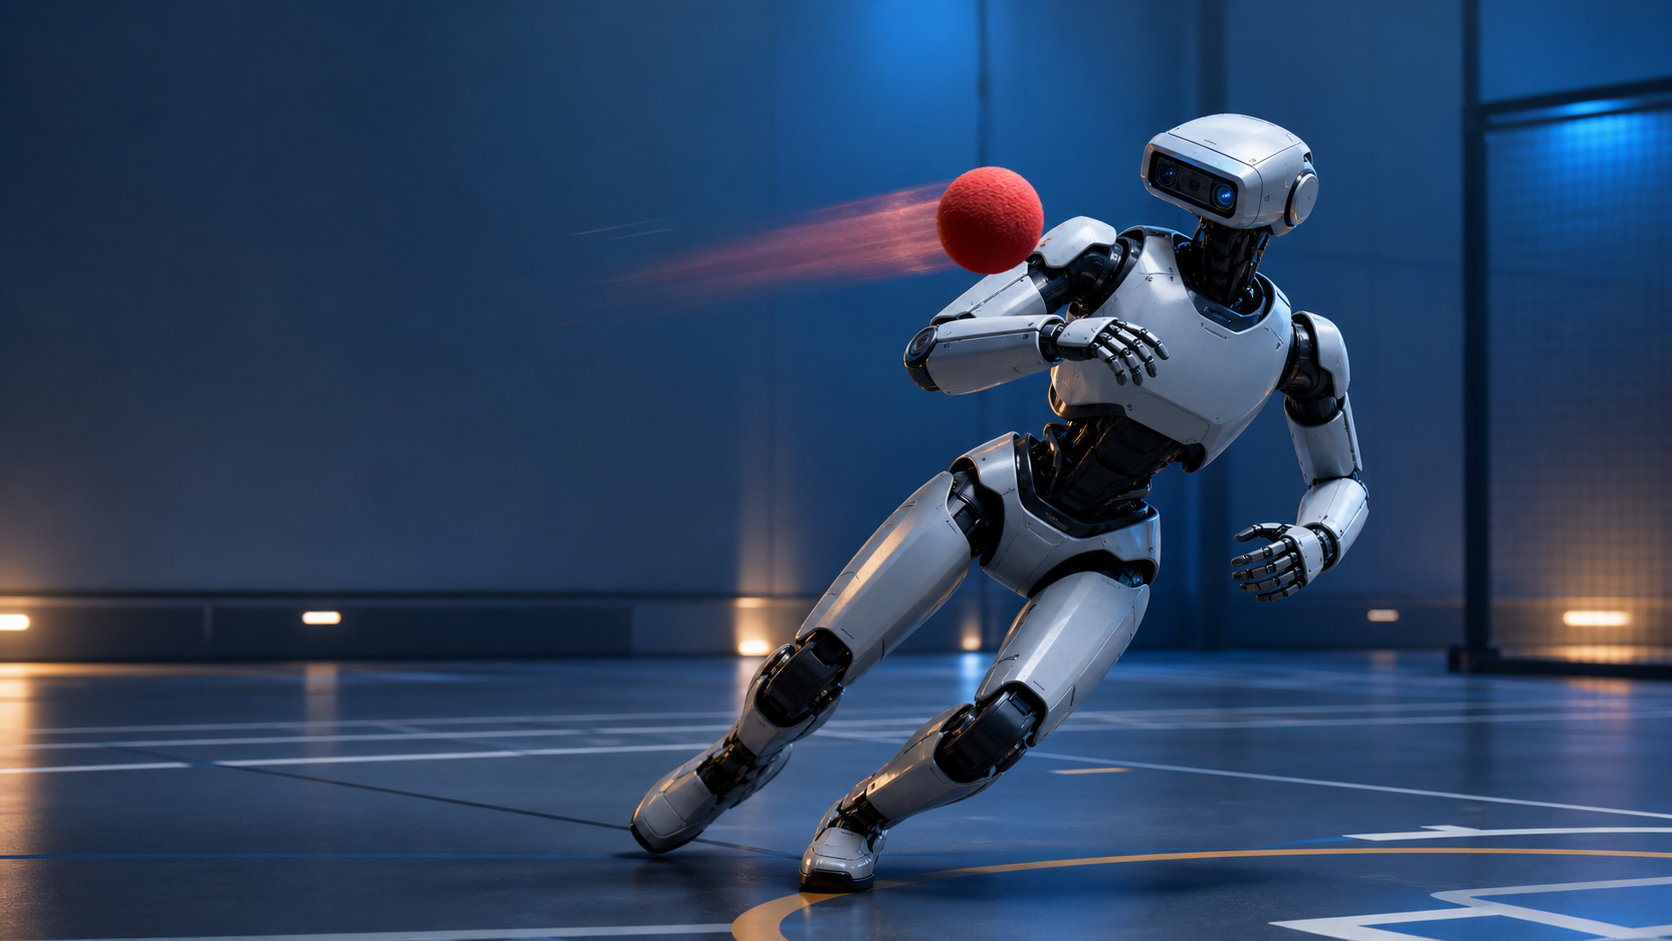
머리에 깊이 카메라를 단 휴머노이드 로봇이 PAC-MAN의 실제 시험에서 날아오는 공의 95%를 피했다. 오늘 아침에는 7만5천 건 규모 체화 AI 데이터, 별도 학습이 필요 없는 3D 질의응답, 물리 변화를 먼저 설명하는 세계 모델, 연산량을 줄인 시각 확산 모델, 적은 데이터로 학습한 3D 생성기, 장시간 영상 검색, 실제 장애 대응을 본뜬 코딩 에이전트 평가, 비동기 다중 에이전트 협업 연구도 나왔다. 2027년 교육 컨퍼런스 일정도 새로 추가했다. 별도 설명이 없는 연구 결과는 새 사전 공개 논문 저자들의 보고이며 독립적으로 재현되지 않았다.
밤사이 새로 나온 소식
- arXiv의 7월 31일 발표분에 휴머노이드 제어, 체화 AI 데이터, 물리 세계 모델, 시각 생성, 3D 추론, 장시간 영상 검색, 코딩 에이전트 평가, 다중 에이전트 협업 연구가 새로 올라왔다.
- AASA는 2027년 2월 25~27일 애틀랜타에서 여는 전국교육컨퍼런스의 개인 등록과 기업 전시 신청을 시작했다.
로봇과 체화 AI 데이터, 공간 이해
PAC-MAN, 머리 카메라로 실제 공 95% 피해
Lizhi Yang, Junheng Li, Aaron D. Ames 연구진은 공과 신체 각 부위 사이의 거리를 반영해 휴머노이드의 전신 회피 동작을 학습시켰다. 실제 작동 때는 공의 정확한 좌표를 받지 않는다. 머리에 단 카메라에서 공을 분리한 깊이 영상만 본다.
가벼운 Link-CBF 제어 정책은 실제 환경에서 추가로 학습하지 않고 Unitree G1에 적용됐다. 논문에 따르면 실제 시험에서 날아오는 공의 95%를 피했다. 논문의 통제된 평가에서는 정해진 방식으로 공을 던지고, 신체 어느 부위든 공에 닿으면 실패로 계산한다. 더 정교한 Joint-CBF 방식은 고정 카메라가 공을 정확히 보지 못하자 성능이 떨어졌다. 공을 따라 움직이는 카메라나 실제 작동 때 공의 정답 위치를 주는 장치를 쓰면 다시 좋아졌다. 따라서 95%는 논문의 시험 방식과 단순한 Link-CBF 제어기에 해당하며, 방향과 속도가 제각각인 물체나 복잡한 공간까지 입증한 수치는 아니다.
ACE-Data-0, 시각·동작·소리·촉각을 한 시간축에 담아
Yukang Cao 연구진은 가구가 놓인 집 두 곳을 정밀하게 보정한 촬영 공간으로 만들었다. 1인칭·외부 시점 영상, 전신과 손가락 움직임, 물체 형상과 6축 위치 변화, 소리, 촉각을 같은 시간축에 기록했다.
ACE-Data-0은 50명이 200가지 과제를 수행한 7만5천 건의 기록으로 구성된다. 전체 길이는 150시간, 영상은 1천700만 프레임이다. 연구진은 현재 기법들이 접촉, 가림, 카메라 움직임, 긴 작업에서 여전히 크게 흔들린다고 보고했다. 집 두 곳만으로 실제 가정의 다양성을 대표할 수는 없다. 대신 지각·동작·접촉을 맞춰 놓은 자료로 모방 학습과 세계 모델을 함께 시험할 수 있다.
ViewMind3D, 방을 완전히 복원하지 않고 공간 질문에 답해
Ping-Kun Chiang 연구진은 질문과 관련된 카메라 시점을 고른 뒤, 언어로 물체를 찾고 위에서 본 방향 단서를 더해 답을 만든다. ViewMind3D는 3D 전용 추가 학습이나 방 전체의 3D 복원이 필요 없다.
SQA3D 전체 정확도는 50.8%, ScanQA CIDEr 점수는 73.4였다. 연구진은 특히 공간 위치를 묻는 유형에서 나아졌다고 보고했다. 다만 정해진 실내 장면 데이터로 얻은 결과다. 카메라와 물체가 계속 움직이는 게임 세계에서는 아직 시험하지 않았다.
세계 모델과 시각 생성, 3D 자산
PhiZero, 물리 변화를 설명한 뒤 영상으로 그려
Shuyao Shang 연구진은 세계의 변화를 짧은 이산 표현인 ‘물리 언어’로 나타냈다. PhiZero는 다음에 일어날 변화를 물리 언어 문장처럼 먼저 예측하고, 그 결과를 영상으로 그린다. 모든 물리 법칙을 픽셀 예측 안에만 숨겨 두는 방식과 다르다.
연구진은 영상 생성과 이해 평가에서 성능이 좋아졌고, 행동에 따른 시뮬레이션과 별도 학습 없는 움직임 전이도 가능했다고 밝혔다. 초록에는 전체 성능 차이를 보여 주는 단일 수치가 없다. 게임 규칙 유지, 충돌 처리, 플레이어 목표도 검증하지 않았다. 개발자가 중간 물리 언어를 직접 살펴보거나 고칠 수 있는지도 시험하지 않았다.
Chimera, 완전 어텐션보다 연산 효율 7.3배 보고
Chongjian Ge 연구진은 긴 맥락을 선형 연산으로 추적하는 장치, 간헐적인 전체 어텐션, 짧은 합성곱, 희소 전문가 혼합 계층을 하나의 시각 확산 모델에 결합했다. 서로 다른 모듈을 따로 조정한 뒤 이미지와 영상 학습에 연산 예산을 어떻게 나눌지 계산했다.
Chimera는 전체 매개변수 110억 개 가운데 한 번에 20억 개를 사용한다. 사전 학습 확산 손실을 기준으로 전체 시스템의 연산 효율은 같은 규모의 완전 어텐션 Wan-2.1 2B보다 7.3배 높았다. 5초 영상으로 학습한 모델은 길이별 추가 학습 없이 30초 영상을 만들었다. 마지막 5초의 FID 저하는 6.5%였다. 확산 손실과 FID만으로는 지시 반영, 등장 대상의 일관성, 편집 편의성을 판단할 수 없다.
ROAD, 기준 모델 데이터의 1.5%로 3D 생성기 학습
Xiao Luo 연구진은 3D를 구분하고 이해하도록 학습한 기존 모델을 확산 트랜스포머의 학습 교사로 썼다. 한 방식은 전체 의미를 맞추고, 다른 방식은 두 잠재 공간의 세밀한 기하 구조를 대응시킨다. 학습이 끝나면 교사 모델은 추론 때 필요 없다.
ROAD는 산업용 기준 모델 Step1X-3D가 쓴 학습 데이터의 1.5%만으로 비슷한 생성 성능을 냈다고 보고했다. 코드는 공개됐다. 초록에는 실제 학습 시간, 메시 위상 구조, 리깅, 게임 엔진 불러오기 결과가 없다. 따라서 이 수치는 제작 가능한 3D 자산의 완성도보다 데이터 효율을 보여 준다.
ReToken, 학습 토큰 하나로 장시간 영상의 근거 찾아
Yao Xiao 연구진은 미리 채운 키-값 캐시에서 질문과 관련된 시각 토큰만 고르는 임베딩 하나를 학습했다. 작은 이미지 질의응답 데이터만 사용했고, 학습과 장시간 영상 추론을 H100 한 대에서 실행했다.
Visual Haystacks에서 Qwen3-VL-8B는 13.4점, InternVL3.5는 12.4점 올랐다. 영상 전용 학습 없이 LVBench로 옮겼을 때도 Qwen3-VL-8B가 8.0점 상승했다. 이 평가는 검색과 질의응답을 다룬다. 영상 생성이나 가상 세계의 상태 유지 능력을 측정한 결과는 아니다.
GenEvA, 떨어져 있는 영상 단서를 한데 모아
Bowen Liu 연구진은 좋은 프레임을 고르는 것만으로는 서로 다른 순간의 단서를 결합하기 어렵다는 문제를 다뤘다. GenEvA는 질문과 관련된 프레임에서 압축된 잠재 표현을 만들고, 여러 시점의 단서가 필요하다고 판단할 때만 이를 답변에 사용한다.
프레임 8장을 썼을 때 LLaVA-Video의 4개 평가 평균은 5.2점, Qwen2.5-VL의 LVBench 정확도는 10.1점 올랐다. 추가된 영상 토큰은 평균 0.11%~0.40%였다. 같은 프레임을 받은 기준 모델과 비교했기 때문에 입력량보다 단서 결합의 효과를 따로 볼 수 있다.
코딩 에이전트와 실제 서비스 장애 대응
ORCA-bench, 6일치 관측 자료와 장애 1,079건 제공
Albert Gong 연구진은 6일치 50GB 규모의 지표, 로그, 추적 정보, 소스 코드를 제공하는 마이크로서비스 시험장을 만들었다. 원인 분석 과제 1,079건은 사용자 신고의 구체성, 장애 발생 후 탐지까지 걸린 시간, 여러 문제가 동시에 발생했는지를 달리한다. 현업 사이트 신뢰성 엔지니어가 정답을 확인했고, 자동 채점 결과를 사람이 다시 평가했을 때 가중 Cohen의 카파는 0.90이었다.
최전선 에이전트 5종 가운데 최고 원인 진단 정확도는 중간 난도 25.3%, 어려운 난도 10.0%였다. 가장 약한 모델은 장애 보고의 40%에서 가능성 낮은 원인을 지어냈다. 소스 코드 접근을 막자 모든 지표가 나빠졌다. 각 과제는 공개 시험장에서 하나씩 따로 조사했다. 실제 시스템이 더 어렵다는 저자들의 설명은 합리적인 추정이지만, 측정된 운영 장애율은 아니다.
Change2Task, 관리 중인 저장소에서 코딩 과제 다시 만들어
Haomin Qi 연구진은 병합된 풀 리퀘스트를 같은 저장소의 최근 정상 버전에서 실행 가능한 과제로 바꾼다. 패치를 거꾸로 적용하거나, 과거 코드를 새 위치에 대응시키거나, 에이전트가 과제 시작 상태를 복원하게 한다. 정상 기반에서 문제가 있는 상태를 만들고 다시 고친 상태까지 전 과정을 검증한다.
버그 수정, 기능 추가, 테스트 작성, API 이전, 보안 수리로 만들 수 있는 변경 1,130건 가운데 79.6%가 검증된 과제로 완성됐다. 같은 후보를 비교했을 때 풀 리퀘스트만 이용한 방식보다 검증된 과제를 29.2% 더 많이 복원했다. 최근 정상 기반을 재사용하면서 전체 비용도 10.8% 줄었다. 이는 평가 과제를 만드는 성과이며, 에이전트가 그 과제를 해결했다는 뜻은 아니다.
PAIChecker, SWE-bench Verified의 13.6%에서 이슈와 패치 불일치 발견
Manyi Wang, Junjielong Xu, Pinjia He 연구진은 연결된 이슈가 풀 리퀘스트의 실제 변경 내용을 제대로 설명하는지 살폈다. 5가지 불일치 유형을 11개 세부 사례로 나눴고, SWE-bench Verified 사례의 13.6%에서 이슈와 패치가 어긋났다고 보고했다.
다중 에이전트 검사기는 SWE-Gym에서 최대 92.12%, SWE-bench Multilingual에서 91.67%의 이진 분류 정확도를 냈다. 여러 언어 모델을 바꿔도 가장 좋은 성능을 기록했다. 저장소 역사에서 유효한 패치라도 함께 묶인 이슈 설명의 정답 패치가 아닐 수 있다는 결과다.
AgentRadio, 코딩 중인 에이전트끼리 발견 즉시 공유
Xinxing Ren 연구진은 코딩 에이전트 도구에 비동기 대화방, 메시지, 호출 알림 기능을 더했다. 에이전트는 정해진 작업 단계가 끝날 때까지 기다리지 않고, 다른 에이전트가 보낸 내용을 작업 중에 받아 반영할 수 있다.
SWE-Atlas QnA에서 Opus 4.6을 쓴 단일 Claude Code 에이전트는 긴 저장소 질문의 32.3%를 해결했다. AgentRadio의 5단계 절차에 따라 움직인 에이전트 4대는 62.1%를 해결했다. 29.8%포인트 높고, 더 최신인 Opus 4.8 단일 에이전트의 57.2%도 넘었다. 다만 에이전트 수와 협업 방식이 함께 바뀌었으므로, 비동기 메시지만의 효과를 따로 계산할 수는 없다.
행사 일정
AASA, 2027년 개인 등록과 기업 전시 신청 시작
AASA 전국교육컨퍼런스는 2027년 2월 25~27일 미국 애틀랜타 조지아 월드 콩그레스 센터에서 열린다. 선택형 사전 워크숍은 2월 24일 진행한다. 회원과 비회원 모두 개인 등록을 할 수 있으며, 주최 측은 최종 마감일을 밝히지 않았다.
기업 전시 신청은 개인 등록과 별도로 받는다. 10×10피트 기본 부스 가격은 2,450달러부터 시작하며, 신청 마감일은 공개되지 않았다.
다음에 볼 것
- PAC-MAN의 95%가 열린 공간에서도 이어지는지 보려면 던지는 위치와 속도를 바꾸고, 관찰자가 움직이거나 주변이 복잡한 상황도 시험해야 한다.
- ACE-Data-0의 촉각과 물체 상태 기록이 처음 보는 집에서도 영상만 쓴 시연 데이터보다 정책 학습에 도움이 되는지 확인할 수 있다.
- PhiZero와 Chimera는 장시간 상태 유지, 조작 가능성, 지시 반영, 편집 편의성을 실제 제작자가 평가한 결과가 필요하다.
- ROAD의 공개 코드를 통해 실제 학습 예산과 생성한 형상이 리토폴로지, 리깅, 게임 엔진 불러오기 뒤에도 유지되는지 확인할 수 있다.
- ORCA-bench, PAIChecker, Change2Task는 코딩 에이전트의 성능 향상이 더 깨끗하게 만든 과제와 복잡한 장애 자료에서도 이어지는지 비교할 근거를 제공한다.
- AgentRadio는 에이전트 수, 토큰, 실행 시간을 같게 맞추고 단계별 인계 방식과 비교해야 비동기 메시지의 효과를 알 수 있다.
이 한국어 기사는 영어 원문을 번역한 것이며, 번역 과정에서 오류가 있을 수 있습니다. 이 글은 Wonder Bricks AI Agent의 도움을 받아 작성했으며 SunnyLabs가 편집했습니다.