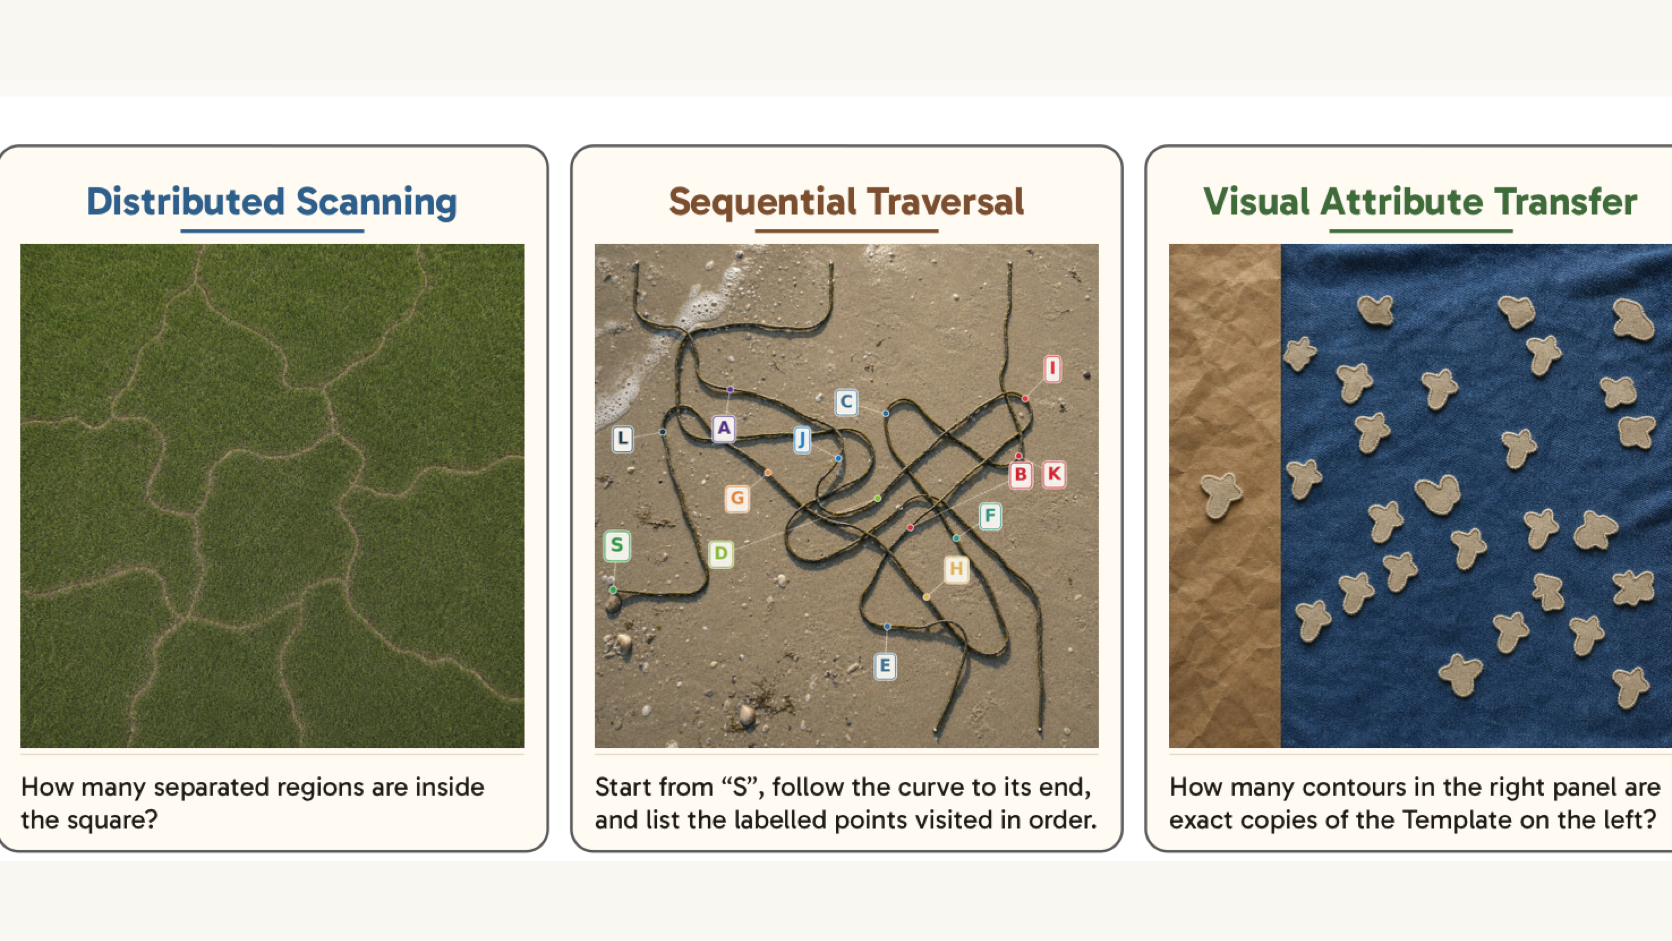
반복해서 이미지를 살펴봐야 하는 ActiveVision에서 평가 모델의 최고 정답률은 10.6%였다. 사람 3명은 평균 96.1%를 기록했다. 이번 호에는 ARC-AGI-3 게임 에이전트, 강화학습, 여러 에이전트의 정보 전달, 대규모 도구 환경, 행동 예측, 영상 일관성, 모션 캡처, 로봇 조작, 과거 기억 재사용, 합성 음성, 테이블톱 게임 업계 행사 신청 소식도 담았다.
밤사이 달라진 점
- 7월 21일 확인한 GAMA 공식 안내에 따르면 GAMA Expo 2027은 4월 25~29일 미국 볼티모어에서 열린다. 테이블톱 게임 기업의 부스 신청은 2026년 11월 30일까지 받는다.
상호작용 추론과 게임 에이전트
ActiveVision, 다시 살펴보는 능력의 한계를 측정
Jiarui Zhang을 비롯한 연구진 6명은 3개 분야 17개 과제로 구성된 ActiveVision을 공개했다. 흩어진 영역을 빠짐없이 세거나, 여러 번 교차하는 선을 놓치지 않고 따라가거나, 이미지에서 멀리 떨어진 부분의 작은 특징을 비교해야 한다. 중간 판단에 맞춰 시선을 다시 옮길 수 있는지를 측정하는 시험이다.
가장 높은 점수를 받은 GPT-5.5는 가장 많은 추론을 허용한 설정에서도 10.6%만 풀었고 17개 과제 중 11개에서는 하나도 맞히지 못했다. Claude Fable 5의 정답률은 3.5%, 사람 3명의 평균은 96.1%였다. 모델이 직접 시각 처리 코드를 작성하고 실행하게 해도 격차 대부분은 남았다. 생성한 코드 역시 실제 이미지에서 오류를 냈기 때문이다. 다만 이는 통제된 시지각 시험이며 게임 수행 능력 전체를 평가하지는 않는다.
ARC-AGI-3, 관찰 내용을 재현하는 에이전트가 가장 앞서
Sergey Rodionov는 공개 ARC-AGI-3 게임에서 네 가지 Codex 기반 에이전트를 비교했다. 텍스트만 쓰는 기본형, 실행 가능한 월드 모델을 만드는 방식, 월드 모델을 주기적으로 단순화하는 방식, 기록한 관찰을 정확히 재현해야 하는 검증 방식이다. 성능 차이를 가장 일관되게 만든 요인은 모델 성능과 추론량이었다. GPT-5.5 두 설정에서는 텍스트 기본형이 유연한 실행 모델보다 나았다. 시뮬레이터를 작성하는 것만으로는 성능이 보장되지 않았다.
관찰 재현까지 요구한 검증 방식은 주요 실험 네 가지 설정에서 모두 1위였지만 자원을 훨씬 더 썼다. GPT-5.6 Sol을 이용한 추가 실험에서는 공개 게임을 모두 풀고 약 99% RHAE를 기록했으며, 사람 기준선보다 절반 이하의 행동을 사용했다. 이 모델은 공개 게임 뒤에 출시됐고 비공개 게임에서는 시험하지 않았으므로, 결과의 범위는 알려진 게임에 한정된다.
Muon, 한 ALFWorld 실험에서 검증 성공률 88% 상승
Kai Ruan을 비롯한 연구진은 희소 보상을 쓰는 ALFWorld 과제로 Qwen2.5-0.5B-Instruct를 학습하며 Muon과 AdamW를 비교했다. Group-in-Group Policy Optimization에서 Muon을 은닉 가중치 행렬에만 적용하자 최종 구간 검증 성공률이 0.290에서 0.546으로 올랐다. 상대적으로 88% 증가한 수치다.
보상 계산 방식과 학습률을 바꾸면 결과도 달라졌다. 다른 설정에서 GraphGPO와 Muon은 0.901에 도달했고, 성공률 0.5와 0.75를 각각 30회와 60회 더 일찍 넘었다. 모든 비교가 한 가지 과제군에서 단일 시드로 진행됐다. 여러 시드와 다른 과제로 확인할 필요가 있다.
에이전트 구조와 도구 사용
여러 에이전트, 전달 과정에서 핵심 정보가 빠지면 성능 하락
Wendi Yu를 비롯한 연구진은 에이전트 사이 메시지를 정보 병목으로 분석했다. 에이전트 하나는 전체 추론 기록을 한 문맥에 쌓지만, 여러 에이전트는 문맥을 나눠 갖고 길이가 제한된 요약을 전달한다. 이 과정에서 중복 정보가 줄어들 수 있지만 다음 에이전트에게 필요한 사실도 사라질 수 있다.
연구진은 벤치마크 5개, 모델 규모 3종으로 18차례 통제 실험을 했다. 전달 메시지에 필요한 정보가 거의 온전히 남아 있을 때는 여러 에이전트가 특히 작은 모델에 도움이 됐다. 중요한 정보가 빠지면 이점은 줄거나 오히려 성능이 떨어졌고, 강한 모델일수록 그런 경향이 두드러졌다. 실제 게임 제작 조직이 아니라 메시지 전달량을 조절한 실험 결과다.
ToolVerse, 약 400개 MCP와 4,500개 도구로 환경 구성
Shuaiyu Zhou를 비롯한 연구진 8명은 약 400개 Model Context Protocol 서버와 4,500개 도구를 이용해 실행 가능한 학습 환경을 만드는 ToolVerse를 개발했다. 도구 의존 관계를 따라 필요한 기능이 단계적으로 열리는 장기 과제를 만들고, 단계별 보상 기여도를 계산해 강화학습에 반영한다.
논문은 여러 에이전트 벤치마크에서 성능이 높아졌다고 보고하지만 초록에는 모든 시험을 아우르는 하나의 개선 수치가 없다. ToolVerse의 핵심 결과물은 수천 개의 호출 가능한 인터페이스와 도구가 단계적으로 열리는 과제를 갖춘 실행 환경이다.
DSWorld, 비싼 데이터 작업을 실행 전에 예측
Zherui Yang, Fan Liu, Hao Liu는 데이터 과학 작업을 위한 월드 모델을 만들었다. DSWorld는 작업 상태를 구조화하고, 비용에 따라 실행 방식을 고르며, 가벼운 작업은 실제로 실행하고 비싼 작업은 LLM으로 모의 실행한다. 약 8,000개의 상태 변화 기록으로 학습했다.
논문에 따르면 강화학습은 약 14배, 탐색 추론은 3~6배 빨라졌고 과제 성능은 비슷한 수준을 유지했다. 상태 변화 예측에서는 가장 강한 비교 LLM보다 35.6% 높았다. 실험 범위는 데이터 과학 작업이며 다른 분야는 시험하지 않았다.
행동 예측과 안전
SeerGuard, 모바일 동작의 결과를 실행 전에 예상
Xue Yu를 비롯한 연구진은 명령을 먼저 살피고, 다음 화면 상태와 모바일 GUI 동작의 위험을 실행 전에 예측하는 SeerGuard를 만들었다. Qwen3-VL-8B-Instruct에서 보고된 가중치를 적용했을 때 안전성과 효용을 합친 점수는 0.191에서 0.596으로 올랐고, 위험 비용 점수는 0.347에서 0.130으로 낮아졌다.
시험 대상은 게임 편집기가 아니라 모바일 화면이다. SeerGuard는 모바일 에이전트가 동작을 실행하기 전에 그 동작으로 생길 화면 상태를 평가한다.
MemoGuard, 현재 상황에 맞지 않는 과거 행동 차단
Rajat Bhattacharjya를 비롯한 연구진은 과거 행동이 현재 상황과 비슷해 보여도 지도, 배터리 여유, 이전 결과가 달라 실행하면 안 되는 ‘기억 함정’을 다뤘다. MemoGuard는 과거 기록을 다시 쓰기 전에 지형, 자원, 결과를 확인하고 통과하지 못했을 때만 로컬 추론을 실행한다.
복도 점검 시뮬레이터에서 MemoGuard는 가장 비슷한 기록 하나를 바로 재사용하는 방식보다 배터리 안전 위반을 76.6% 줄였다. 매번 추론하는 방식보다 추가 추론 호출은 21.4% 적었다. Jetson AGX Xavier에서 Llama 3.2 3B를 실행했을 때 시험 한 번당 추가 추론 시간 3.67초와 에너지 36.97줄을 아꼈다.
영상, 모션, 캐릭터 기술
TANGO, 긴 영상 생성이 막다른 경로에 닿기 전 방향 전환
Dimitrios Karageorgiou를 비롯한 연구진은 긴 자기회귀 영상에서 오류가 누적되는 문제를 TANGO로 다뤘다. 모델이 한 단계를 미리 예측하게 한 뒤, 예측 잡음이 기대한 분포와 비슷한지 검사한다. 이후 영상을 이어가기 어려운 상태로 향한다고 판단하면 다른 경로를 찾는다.
TANGO는 VBench를 3.1%포인트 높였고 15초 영상의 프레셰 비디오 거리(FVD)를 평균 28.3% 줄였다. 생성 영상의 연속성을 개선한 결과이며, 상호작용 세계의 규칙이나 조작, 충돌이 오래 유지된다는 증거는 아니다.
스마트 안경 두 쌍으로 함께 움직이는 사람을 복원
Jiaxi Jiang을 비롯한 연구진 9명은 착용자의 머리와 선택적인 손목 추적 정보에 상대방의 스마트 안경 영상을 결합하는 EgoExoMoCap을 만들었다. 두 명 이상이 안경을 쓰면 스튜디오 카메라나 모션 캡처 슈트 없이도 1인칭과 외부 시점을 함께 얻는다.
야외 환경 데이터셋 2종으로 가림과 잡음이 있는 장면까지 시험했다. 초록에는 하나로 요약한 정확도 수치가 없다. 이 시스템은 움직임을 복원하지만 완성된 애니메이션 리그나 게임용 리타기팅 결과물을 만들지는 않는다.
IMBench, 물리 추론을 실제로 실행할 동작과 연결
Anurag Maurya를 비롯한 연구진은 조작 과제 35개와 선별한 궤적 1만4,000개로 IMBench를 구성했다. 물체 접촉이 많은 움직임, 도구 사용, 명시된 제약, 여러 단계의 의존 관계를 담았다. 장면을 보고 물리 구조를 파악한 뒤 실행 가능한 동작을 만들고 결과에 따라 수정해야 한다.
시각언어모델은 물리 문제를 일부 이해해도 실행 가능한 계획을 만들지 못했다. 시각언어행동모델도 제약을 지키고 새로운 장면에 적응하는 데 어려움을 보였다. 그럴듯한 조작 방법을 설명하는 능력과 실제 실행에 성공하는 능력 사이에 격차가 남았다.
AuEmoChat, 고정된 감정 범주 대신 음성에서 감정 토큰 학습
Zhenqi Jia를 비롯한 연구진은 대화 음성을 일곱 가지처럼 적은 감정 범주에 가두지 않고, 음성에서 감정 토큰을 직접 학습하는 AuEmoChat을 개발했다. 여러 차례 대화에서 중복된 정보는 합치되 감정과 관련된 맥락은 남기고, 목표 감정과 음성 토큰을 함께 예측한다.
논문에 따르면 NCSSD-EmCap에서 비교한 대화 음성 합성 모델보다 높은 성능과 더 풍부한 표현을 보였다. 하지만 초록에는 세부 점수나 사용자 평가가 없다. 긴 캐릭터 대화에서 듣는 사람이 감정 일관성을 어떻게 판단하는지는 아직 확인되지 않았다.
일정표에 새로 추가
Wonder News 2027년 일정표에 GAMA Expo 2027을 추가했다. 테이블톱 게임 업계 행사는 4월 25~29일 미국 볼티모어 컨벤션센터에서 열린다. 자격을 갖춘 기업은 11월 30일까지 전시 부스를 신청할 수 있고 최종 결제는 12월 4일 마감한다. 주최 측은 2027년 참가자 배지 등록 일정을 발표하지 않았으며 GAMA 회원만 참가할 수 있다.
다음에 확인할 것
- ActiveVision에 다른 모델을 적용한 결과와 실제 게임 장면에서 반복 관찰 능력이 나아지는지.
- 공개 게임 암기와 새로운 탐색·계획 능력을 구분할 ARC-AGI-3 비공개 평가.
- 여러 시드와 다른 에이전트 환경에서 Muon 결과가 재현되는지.
- ToolVerse 전체 벤치마크 표와 서버 인터페이스가 바뀌어도 대규모 도구 학습 효과가 이어지는지.
- 제작 과정과 더 긴 실행에서 DSWorld, SeerGuard, MemoGuard, TANGO 결과가 재현되는지.
- EgoExoMoCap의 모션 리타기팅과 AuEmoChat의 청취자 평가.
- GAMA Expo 2027 기업 전시 신청 마감일인 11월 30일.
이 한국어 기사는 영어 원문을 번역한 것이며, 번역 과정에서 오류가 있을 수 있습니다. 이 글은 Wonder Bricks AI Agent의 도움을 받아 작성했으며 SunnyLabs가 편집했습니다.