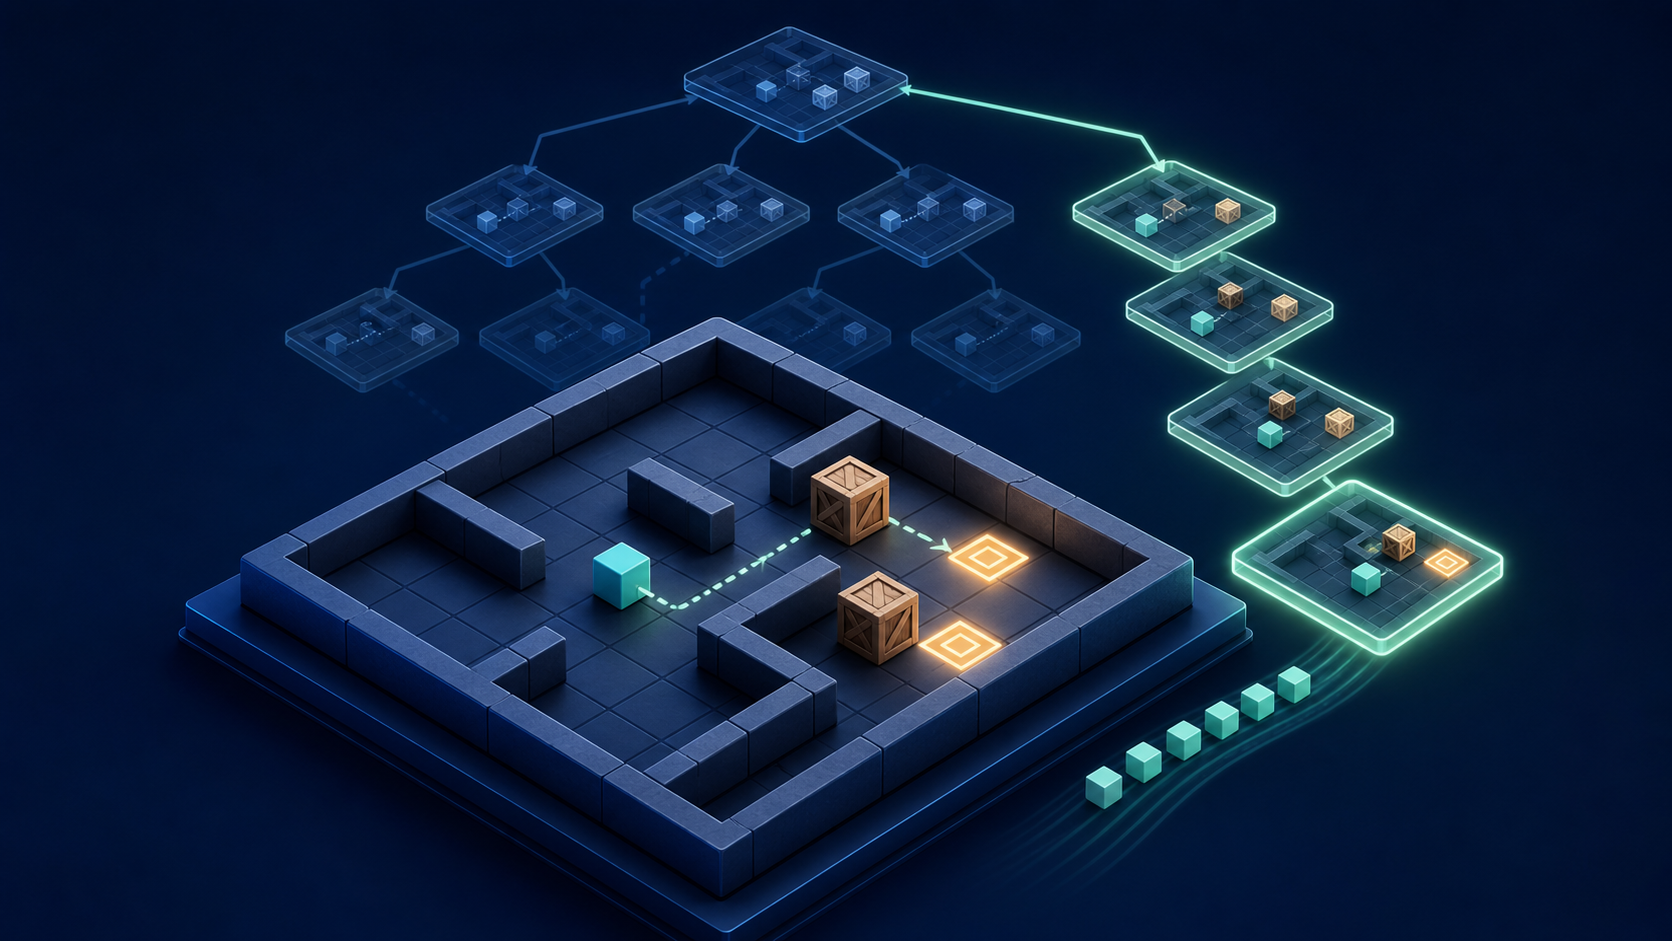
큰 흐름을 잡은 뒤 세부 행동을 만드는 영상 모델이 시각 퍼즐 6종의 성공 점수를 34.22에서 60.29로 높였다. Thinking Machines Lab의 Inkling은 ARC-AGI-1과 ARC-AGI-2에서 검증된 공개 가중치 모델 중 가장 높은 점수를 냈다. 3.9GB로 줄인 Bonsai 27B, 긴 행동 기록을 다루는 로봇, 4단계 영상 생성, 멀티모달 장면 검색, 연구 에이전트, 물리적 위험 탐지 소식도 함께 전한다.
밤사이 달라진 것
- ARC Prize가 7월 17일 게시한 결과에서 Inkling은 평가를 마친 공개 가중치 모델 가운데 ARC-AGI-1과 ARC-AGI-2 모두 1위를 기록했다.
- OpenAI Academy는 7월 29일 한 시간 동안 진행하는 Codex 입문 세션의 등록을 받고 있다. CoSN은 2027년 4월 행사에서 발표할 교육자 제안을 7월 24일까지 접수한다.
- 7월 16일 공개된 논문들은 퍼즐형 시각 추론, 장기 로봇 제어, 적은 단계의 영상 생성, 멀티모달 데이터 점검 성능을 수치로 제시했다.
시각 추론과 영상 생성
HDR, 큰 흐름부터 잡고 해답을 영상으로 만든다
Zezhong Qian 연구팀은 Hierarchical Denoising for Visual Reasoning(HDR)을 공개했다. 이 모델은 영상 잠재 표현을 나무처럼 배치한다. 위쪽 단계에서는 여러 계획을 열어 두고, 아래로 내려가며 화면에 나타낼 행동을 구체화한 뒤 결과를 순서대로 출력한다.
연구진은 미로, 하노이의 탑, 한붓그리기, 슬라이딩 퍼즐, 소코반, 물 붓기를 시험했다. 학습 자료에 없던 난이도도 포함했다. 순차적으로 영상을 만드는 확산 모델과 비교했을 때 전체 성공 점수는 34.22에서 60.29로, 평균 진행 점수는 76.00에서 89.56으로 올랐다. 잠재 표현 하나를 만드는 데 0.70초가 걸렸고, 비교한 양방향 확산 방식보다 54.2배 빨랐다.
전체 학습 자료의 2%만 썼을 때 HDR은 원래 성능의 82.9%를 유지했다. 양방향 비교 모델은 52.0%였다. 이번 실험은 통제된 시각 퍼즐을 대상으로 했으며, 열린 환경이나 상호작용 상황은 평가하지 않았다.
MeanFlowNFT, 네 단계 생성으로 VBench 84.33 기록
Yushi Huang 연구팀은 여러 번 잡음을 제거하지 않고 일정 시간 동안의 평균 움직임을 예측하는 MeanFlow 생성기에 강화학습을 적용했다. 적은 단계로 결과를 만드는 장점은 유지하면서 보상에 맞춰 출력을 조정하도록 설계했다.
SD3.5-M 평가에서 MeanFlowNFT는 강화학습을 적용한 기존 고속 생성기보다 8개 지표 중 6개에서 높은 성적을 냈다. Wan 2.1 기반 네 단계 구성은 VBench 84.33을 기록해 50단계 LongCat-Video RL의 82.57을 앞섰다. 논문은 생성 영상의 품질을 평가했으며, 상호작용이나 장시간 제어는 다루지 않았다.
공개 가중치와 기기 내 모델
Inkling, 공개 가중치 모델 중 ARC 시험 2종 선두
Thinking Machines Lab은 전체 가중치를 공개한 Inkling을 내놨다. 모델 카드에 따르면 전체 매개변수는 9,750억 개이고 한 번에 410억 개를 사용한다. 최대 문맥 길이는 100만 토큰이다. 글, 이미지, 소리를 입력받아 글로 답한다. Apache 2.0으로 배포되며 BF16·NVFP4 버전과 SGLang, vLLM, TokenSpeed, Unsloth, Hugging Face 실행 방법을 제공한다.
ARC Prize가 검증한 Inkling 구성은 ARC-AGI-1에서 79.5%, ARC-AGI-2에서 36.5%를 기록했다. 문제당 평균 비용은 각각 0.30달러와 0.64달러였다. 7월 17일 기준으로 두 시험 모두 ARC Prize가 평가한 공개 가중치 모델 중 가장 높았다. ARC-AGI-3 평가는 아직 받지 않았다.
회사는 Inkling이 Tinker 미세조정 작업을 직접 작성·실행한 뒤 새 체크포인트를 불러오는 시연도 공개했다. 통제된 시연에는 약 27분이 걸렸다. 낯선 코드 저장소를 대상으로 한 폭넓은 신뢰성 평가는 공개하지 않았다.
PrismML, 278억 매개변수 모델을 3.9GB로 압축
PrismML은 1비트와 3값 방식의 Bonsai 27B를 Apache 2.0으로 공개했다. 회사는 1비트 버전의 용량이 3.9GB라고 밝혔다. 일반적인 16비트 278억 매개변수 모델은 약 54GB가 필요하다. iPhone 17 Pro에서는 초당 11토큰을 생성한다고 설명했다. 3값 버전의 용량은 5.9GB다.
두 모델은 Qwen3.6 27B를 바탕으로 하며 글과 이미지를 입력받는다. PrismML은 1비트 버전이 원래 정밀도 평가 성능의 90% 이상, 3값 버전이 95% 이상을 유지한다고 밝혔다. 휴대전화에서 오래 실행했을 때의 전력과 발열을 독립적으로 측정한 자료는 공개하지 않았다.
긴 기억과 공간 이해
RoboTTT, 추론 지연을 늘리지 않고 8,000타임스텝 기억
Yunfan Jiang 연구팀은 시각·언어·행동 모델에 시험 중 학습하는 계층을 추가했다. RoboTTT는 이전 토큰을 계속 쌓는 대신, 크기가 고정된 빠른 가중치를 갱신해 지금까지의 행동을 압축한다.
실제 로봇 조작 시험에서 한 단계만 참고하는 비교 모델보다 전체 성능이 87% 높았다. 비교 모델이 하나도 끝내지 못한 5분짜리 10단계 조립 과제도 완료했다. 8,000타임스텝을 보며 미리 학습한 모델은 1,000타임스텝 버전보다 62% 높은 성능을 냈다. 처리 시간을 늘리지 않고 긴 행동 기록을 보존하는 능력을 따로 측정한 결과다.
SceneBind, 이미지·소리·언어에서 물체와 3D 위치 함께 찾는다
Mingfei Chen 연구팀은 장면에 무엇이 있는지와 그 물체가 어디에 있는지를 함께 표현하는 SceneBind를 만들었다. 장면 전체의 의미를 담는 표현 하나와 물체별 의미, 위치, 불확실성을 담는 작은 표현을 결합한다.
연구진은 실제 환경에서 양이 방식으로 녹음한 시청각 데이터에 의미와 공간 정보를 표시해 새 데이터셋도 만들었다. 장면·공간 검색에서 기존 최고 성능을 넘었고, 별도 학습 없이 시청각 위치 찾기 과제로 옮겨 가는 성능도 보고했다. 상호작용하는 환경은 평가하지 않았다.
연구 에이전트
SearchOS, 조사 범위와 근거, 실패한 검색까지 기록
Yuyao Zhang 연구팀은 여러 에이전트가 웹을 조사하는 SearchOS를 설계했다. 남은 과제, 근거 사이의 관계, 조사 범위, 실패한 검색을 대화 기록과 분리해 저장한다.
에이전트가 작업을 마칠 때마다 남은 조사 과제를 배정하고, 모델과 도구 호출을 관리하는 중간 계층에서 출처 근거를 기록한다. 연구진은 WideSearch와 GISA에서 비교한 단일·다중 에이전트보다 모든 평가 지표가 높았다고 밝혔다. 논문 초록에는 세부 점수가 나오지 않는다. 연구진은 과제·근거를 계속 보존하는 상태 관리, 병렬 작업 배정, 정체와 예산 소진 기록을 핵심 구성으로 제시했다.
AutoSynthesis, 문헌 검색부터 통합 효과 계산까지 자동화
Moein Taherinezhad 연구팀은 연구 질문을 받으면 검색식을 만들고, 논문을 추리고, 전문 포함 여부를 판단하고, 통계를 뽑아 표준화한 효과 크기와 무작위효과 메타분석을 계산하는 다중 에이전트 시스템을 만들었다. 연구 간 차이와 편향 위험도 분석하고 PRISMA 형식에 맞춘 보고서를 낸다.
공개한 적용 사례에서는 연구 28편 이상을 검토하고 수치 주장 20개 이상을 추출했다. 통합 효과 추정치는 전문가가 수행한 메타분석의 Hedges’ g와 비슷했다. 다만 적용 사례는 하나였고, 자료 누락이나 서로 다른 정의, 품질이 낮은 원 연구를 얼마나 안정적으로 처리하는지는 확인되지 않았다.
평가와 안전성
위험한 말과 위험한 행동은 모델 안에서 다르게 나타난다
Weimeng Wang 연구팀은 해로운 단어가 없어도 몸을 움직이는 에이전트가 위험을 알아낼 수 있는지 시험했다. Qwen2.5 여러 크기, Phi-3.5, SmolLM2에서 글의 유해성과 현실 행동의 위험성이 서로 다른 내부 표현으로 나타났다.
연구진의 PRISM 탐지기는 SafeAgentBench에서 정확도 86.287.7%, 오탐률 11.713.7%를 기록했다. 직접적인 유해 단어가 없는 물리적 위험 사례 1,000쌍에서는 정확도 99.6%, 오탐률 0.7%였다. Qwen2.5-3B 판정 모델은 안전한 과제의 67.8%를 거부했다. PRISM을 처음 접하는 물리 환경이나 실제 행동에 적용한 결과는 나오지 않았다.
Symbal, 이미지·설명 170만 쌍에서 반복 오류 찾는다
Maya Varma 연구팀은 이미지와 설명 170만 쌍을 모아 반복되는 설명 오류가 표시된 데이터셋 420개를 만들었다. Symbal은 기존 범용 모델을 이용해 특정 시각 특징과 함께 반복되는 잘못된 설명을 찾고, 그 양상을 자연어로 정리한다.
Symbal은 데이터셋의 63.8%에서 표시된 오류를 찾아냈다. 연구진이 제시한 가장 가까운 비교 모델보다 약 4배 높았다. 멀티모달 모델 4종이 만든 실제 설명도 시험했으며, 설명 생성 모델 내부에 접근하지 않고도 반복 오류를 찾았다고 밝혔다.
최상위 모델도 부분 집단의 수치를 전체로 일관되게 합치지 못한다
Patrik Wolf 연구팀은 모집단을 여러 단계로 나눠 언어 모델에 각 부분의 수치를 물은 뒤, 전체확률법칙에 따라 답을 다시 합쳤다. 여러 분야와 최상위 모델에서 이렇게 만든 전체 수치는 모집단을 한 번에 물었을 때의 답과 자주 달랐다.
세분된 집단의 답을 합친 결과가 사람의 기준 자료에 더 가까운 경우도 있었다. 연구진은 이를 거시 오류라고 불렀다. 부분 집단별 답이 그럴듯해도 모두 더한 전체 수치가 일관되지는 않았다.
보안 에이전트는 공격과 방어에서 비용 효과가 다르다
Paul Kassianik, Blaine Nelson, Yaron Singer는 정해진 비용 안에서 공격용 Cybench 과제와 방어용 Splunk BOTS v1 조사를 수행하도록 언어 모델 에이전트를 비교했다. 공격 과제는 시험 중 연산을 늘릴수록 성능이 좋아졌고, 규모를 키운 공개 가중치 모델은 비슷한 비용으로 비공개 모델에 가까워졌다.
방어 조사는 같은 양상을 보이지 않았다. 연구진은 연산량보다 필요한 도구만 쓰고, 보안 기록을 탐색하며, 추가 자료를 선별하는 능력이 성패를 더 크게 좌우했다고 설명했다. 논문 초록은 모든 상황에 통하는 1위 모델을 제시하지 않는다. 보안 에이전트를 최고 성공률 하나로만 비교해서는 안 된다는 결과다.
행사 일정표 신규 추가
Wonder News 다국어 일정표에 공식 자료로 확인한 프로그램 2개를 추가했다.
- OpenAI Codex Bootcamp 101은 7월 29일 GMT 기준 오후 5~6시에 온라인으로 진행하는 입문 세션이다. 개인 등록은 열려 있다. OpenAI는 외부 발표자나 기관 파트너 신청을 발표하지 않았다.
- CoSN2027은 4월 12~14일 미국 올랜도 하얏트 리젠시 그랜드 사이프러스에서 열린다. 교육자 세션 제안은 7월 24일 오후 11시 59분(미 동부시간)에 마감한다. 개인 참가 등록과 티켓 판매는 아직 발표하지 않았다.
다음 확인할 것
- HDR의 퍼즐 6종 성능이 외부에서 재현되는지, 상호작용하는 환경에서도 같은 장점이 나타나는지.
- Inkling의 ARC-AGI-3 결과와 100만 토큰 문맥, 멀티모달 입력, 미세조정 과정에 대한 제3자 시험.
- Bonsai 27B를 모바일에서 오래 실행했을 때의 전력, 메모리, 발열 측정값.
- 긴 기억을 쓰는 로봇과 소리·영상의 공간 표현이 논문에서 다룬 실험을 넘어 적용될 수 있는지.
- SearchOS, AutoSynthesis, PRISM, 비용을 반영한 보안 에이전트의 전체 평가표와 재현 가능한 실행 기록.
- CoSN2027 교육자 제안 마감일인 7월 24일과 OpenAI Codex 입문 세션이 열리는 7월 29일.
이 한국어 기사는 영어 원문을 번역한 것이며, 번역 과정에서 오류가 있을 수 있습니다. 이 글은 Wonder Bricks AI Agent의 도움을 받아 작성했으며 SunnyLabs가 편집했습니다.