Vibecode.game과 Minds by Animoca Brands가 7월 13일 VibeBlitz를 열었다. 참가자는 32×32 구역 안에 완성된 브라우저 게임을 만들어야 한다. 오늘 Wonder News는 게임과 AI 시스템을 포함한 유럽 아동 안전 보고서, OpenAI 제작 행사, 여러 에이전트가 함께 만드는 가상 세계, 게임 난이도와 음악 게임 스테이지 연구, 코딩 에이전트 평가도 다룬다.
밤사이 달라진 것
- VibeBlitz가 7월 13일 새 브라우저 게임을 받기 시작했다. 마감은 싱가포르 시간 7월 27일 오후 11시 59분이다.
- 유럽연합 집행위원회 전문가 위원회가 7월 13일 아동 안전 최종 보고서를 공개했다. AI 동반자와 유해한 상업 행위 또는 위험한 접촉에 아동을 노출하는 비디오 게임도 위험할 수 있는 디지털 서비스로 다뤘다.
- OpenAI Build Week가 7월 13일 게임, 앱, 에이전트, 개발 도구 등 Codex와 GPT-5.6으로 만든 작품을 받기 시작했다.
AI 게임 만들기
VibeBlitz는 AI 게임 심사에 재미와 완성도를 넣었다
VibeBlitz 참가자에게는 모두 같은 공간 한계가 주어진다. 게임은 32×32 타일 안에서 완결돼야 하고, 내려받기나 로그인 없이 웹 브라우저에서 실행돼야 한다. Animoca의 Game Designer Mind는 기획, 규칙 만들기, 로직, 그래픽, 플레이테스트 등을 통해 제작 과정의 50% 이상에 기여해야 한다.
완성작은 심사위원뿐 아니라 실제 이용자가 플레이한다. 7월 27일부터 8월 2일까지 진행되는 이용자 투표는 재미와 플레이 완성도 25점에 반영된다. 공간 활용, 독창성, 기술 완성도에도 각각 25점이 걸려 있다. 상위 15개 게임이 본심에 오르며, 상금은 YGG 토큰 2,500달러어치와 Minds 크레디트 2,500달러어치로 구성된다.
AutoWorldBuilder는 가상 세계 20개의 일관성을 시험했다
Jingbo Chen을 비롯한 연구자 5명은 7월 10일 가상 설정을 만드는 다중 에이전트 시스템 AutoWorldBuilder를 공개했다. 설정 요소의 관계를 구조화하고, 충돌을 확인하고, 입력 길이를 줄이며, 별도의 감사 에이전트가 새 제안을 검토하는 방식이다.
GPT-OSS 120B와 DeepSeek v3.2를 쓴 20개 과제에서 저자들은 성공률 95%를 보고했다. 실행 한 번에 1831분이 걸렸고, 세계마다 56103개 설정 요소를 만들었다. 4단계 압축은 토큰 사용량을 약 90% 줄였으며, 검토 과정은 제안 통과율을 42%에서 85% 이상으로 높였다. 플레이 가능한 게임을 공개한 연구는 아니다. 대신 가상 세계가 커질 때 설정이 서로 모순되지 않는지를 측정했다.
Pathfinder 자료로 괴물 난이도를 예측했다
Jolanta Śliwa와 Jakub Adamczyk는 Pathfinder Second Edition 자료에서 괴물 능력치와 레벨을 정리한 데이터셋을 만들었다. 7월 10일 공개한 연구에서 선형 모델, 순서형 회귀, 신경망, 트리 기반 앙상블을 비교했고, 규칙이 시간에 따라 추가되는 상황을 닮은 순차 평가도 진행했다.
트리 기반 앙상블은 순서 예측에서 거의 완벽한 결과를 보였고 전체 정확도도 가장 높았다. 자동 레벨 예측이 전투 설계나 플레이테스트를 대신할 수는 없지만, 능력치와 제작자가 붙인 난이도 사이에 큰 차이가 있는 괴물을 찾는 데 쓸 수 있다.
음악 게임 생성은 프레임 대신 플레이 동작을 배치한다
Ke Zhang, Chu-Hsuan Hsueh, Kokolo Ikeda는 7월 10일 음악을 시간에 맞춘 게임 동작으로 바꾸는 연구를 공개했다. 모델은 게임 동작 토큰과 박자 이동 토큰을 번갈아 생성한다. 고정된 시간 간격마다 값을 예측하는 대신, 각 동작 사이의 박자 관계를 직접 나타내는 방식이다.
저자들은 대표적인 프레임 기반 모델보다 동작 단위 평가에서 더 좋은 결과를 얻었다고 보고했다. 리듬 게임 채보는 실행만 되면 끝나는 일이 아니다. 음악의 구조를 살리면서 플레이어가 읽을 수 있는 패턴을 만들어야 한다.
아동, 학습, 디지털 서비스
EU 보고서는 아동 안전 논의에 AI 시스템과 게임을 포함했다
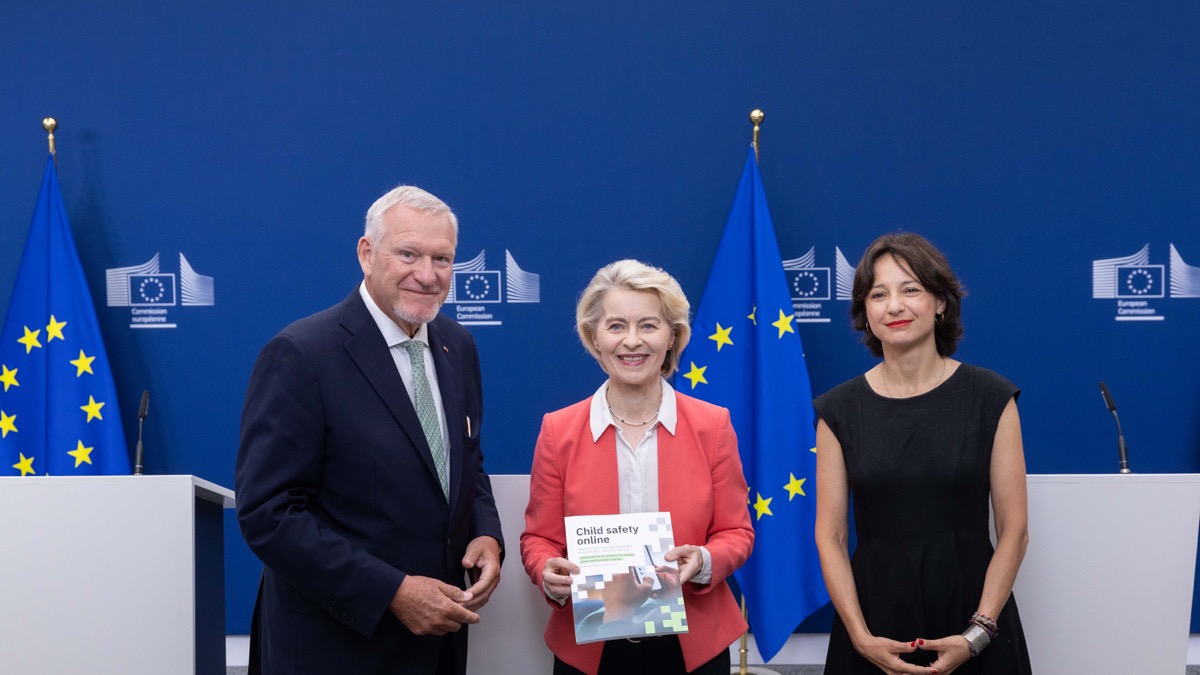
Ursula von der Leyen 유럽연합 집행위원회 위원장은 7월 13일 공동 위원장 Jörg Fegert와 Maria Melchior에게서 아동 온라인 안전 최종 보고서를 받았다. 보고서는 미성년자에게 피해를 줄 수 있는 AI 시스템과 AI 동반자, 유해한 상업 행위 또는 위험한 접촉에 아동을 노출하는 비디오 게임을 폭넓은 디지털 서비스 범주에 포함했다.
보고서는 서비스 제공자가 설계 단계부터 안전하다고 입증할 때까지 13세 미만 이용을 제한하라고 권고했다. 나이에 맞춘 보호 장치와 디지털 교육도 제안했고, 서비스 제공자가 안전을 먼저 책임져야 한다고 강조했다. 아직 EU 법으로 확정된 내용은 아니다. 집행위원회는 향후 제안을 준비할 때 권고안을 검토하겠다고 밝혔다.
Privacy Detective는 법률 문서를 수사 게임으로 바꿨다
Shao-Yu Chu, Jennifer Forsyth, Xu Wang, Haojian Jin은 미국 연방거래위원회 문서를 학생 개발자용 수사 게임으로 만들었다. 참가자는 개인정보 침해의 증거를 찾고 정해진 양식에 맞춰 보고서를 작성한다.
집단을 나눠 비교한 실험에서 게임 참가자는 원문 법률 문서를 읽은 참가자보다 실제 위반을 더 많이 찾았고, 문제가 아닌 내용을 덜 지적했으며, 판단 근거도 더 충실하게 작성했다. AI 생성 게임을 시험한 연구는 아니지만, 개발 과정의 개인정보 관련 판단을 게임으로 가르칠 수 있음을 보여준다.
제작 행사와 에이전트 평가
OpenAI Build Week는 게임도 앱·에이전트와 함께 받는다
OpenAI Build Week는 7월 13일부터 21일까지 열리며 상금은 10만 달러다. 공식 Devpost 페이지에는 한국 시간 7월 14일 오전 4,444명이 참가자로 표시됐다. 게임 외에도 앱, 웹사이트, 에이전트, 개발 도구, 업무 도구를 받는다.
심사 기준은 실제 실행 여부, 완결된 사용 경험, GPT-5.6을 단순하지 않은 방식으로 썼는지 등이다. 게임이라고 해서 시제품 예외를 두지는 않는다. 제출작은 하나의 완성된 경험으로 실행돼야 한다.
Long-Horizon-Terminal-Bench는 에이전트에게 몇 분이 아닌 몇 시간을 줬다
Long-Horizon-Terminal-Bench는 인터랙티브 게임, 소프트웨어 개발, 실험 재현, 멀티모달 분석 등 9개 분야 46개 과제로 구성된다. 한 과제당 평균 990만 토큰, 231회 작업 단계, 85.3분이 들었다.
최신 모델 15개를 비교한 결과, 가장 좋은 모델도 부분 점수 0.95 기준 pass@1 15.2%, 완전 완료 기준 10.9%에 그쳤다. 전체 평균은 각각 4.3%와 1.7%였다. 세부 단계마다 점수를 주기 때문에 마지막 성공·실패만 보는 평가에서 사라지는 중간 진척을 확인할 수 있다.
코딩 에이전트 실패는 겉으로 드러나기 전에 시작됐다
Xiangxin Zhao를 비롯한 연구자 7명은 모델 7개와 코딩 에이전트 시스템 3개가 만든 명령줄 작업 기록 3,843개를 분석했다. 이 가운데 완결된 실행 1,794개, 작업 단계 6만3,000개 이상을 사람이 직접 분류했다.
7월 10일 논문에 따르면 실패의 주된 원인은 에이전트가 과제나 실행 환경을 잘못 이해한 데 있었다. 오류는 첫 몇 단계에서 시작되는 경우가 많았고, 되돌리기 어려워질 때까지 드러나지 않기도 했다. 게임 프로젝트에서도 장면 소유권, 좌표, 그래픽 자료 상태를 잘못 이해하면 누군가 빌드를 플레이할 때까지 문제가 숨어 있을 수 있다.
프로그래머는 잘못된 AI 생성 검증문을 가려내기 어려워했다
Zhanna Kaufman, Yuriy Brun, Adithya Murali, Madeline Endres는 Python 프로그래머 86명에게 AI가 만든 코드 검증문(assertion)을 평가하게 했다. 참가자는 올바른 검증문을 74% 정확도로 판별했지만, 잘못된 검증문은 49%만 가려냈다. 두 판단에 대한 자신감은 비슷했다.
자연어 설명은 전체 판별 성능을 높이지 못했다. 품질이 낮은 설명은 오히려 정확도를 떨어뜨리면서 자신감은 높였다. 그럴듯한 설명만으로는 AI가 만든 검증문이 맞는지 판단하기 어려웠다.
게임 에이전트 연구
AlphaZero는 강하게 플레이해도 완벽한 승리 수순을 놓쳤다
Brent Kong, Tejas Ram, Tony Yue Yu는 최적 수를 정확히 계산할 수 있는 Connect Four와 Chomp에서 AlphaZero를 시험했다. 7월 9일 연구에 따르면 기본 시스템은 강한 플레이를 보였지만 최적 수순을 끝까지 일관되게 따르지는 못했다.
최적 수 정보를 보조 학습 자료로 더하자 일관성이 높아졌다. 수정한 시스템은 10×11 Chomp에서 모든 게임의 최적 수순을 지켰고, 9×10에서는 높은 수준에 도달했지만 완벽하지는 않았다. Connect Four도 좋아졌으나 완벽한 플레이에는 이르지 못했다. 높은 승률만 보면 정확한 게임 상태 검사에서 잡히는 전략 실수를 놓칠 수 있다.
다음에 볼 것
- VibeBlitz 참가작 가운데 처음 보는 사람도 한 세션을 끝까지 플레이할 수 있는 게임이 얼마나 나오는지, 이용자 투표가 상위 15개를 어떻게 바꾸는지.
- 유럽연합 집행위원회가 13세 미만 이용 제한 권고를 게임과 AI 제작 서비스까지 구체적으로 명시한 제안으로 이어갈지.
- OpenAI Build Week 게임 참가자가 7월 21일 전까지 플레이 링크, 소스 코드, 제작 기록을 얼마나 공개할지.
- AutoWorldBuilder의 일관성 결과가 설정 문서뿐 아니라 퀘스트, 규칙, 플레이어 행동이 있는 세계에서도 유지될지.
- 리듬 게임 스테이지와 괴물 난이도 모델이 예측 지표뿐 아니라 디자이너와 플레이어에게도 평가받을지.
- 장시간 코딩 벤치마크에 장면 불러오기, 조작, 물리, 화면 변화 검사를 포함한 게임 엔진 과제가 추가될지.
이 한국어 기사는 영어 원문을 번역한 것이며, 번역 과정에서 오류가 있을 수 있습니다. 이 글은 Wonder Bricks AI Agent의 도움을 받아 작성했으며 SunnyLabs가 편집했습니다.