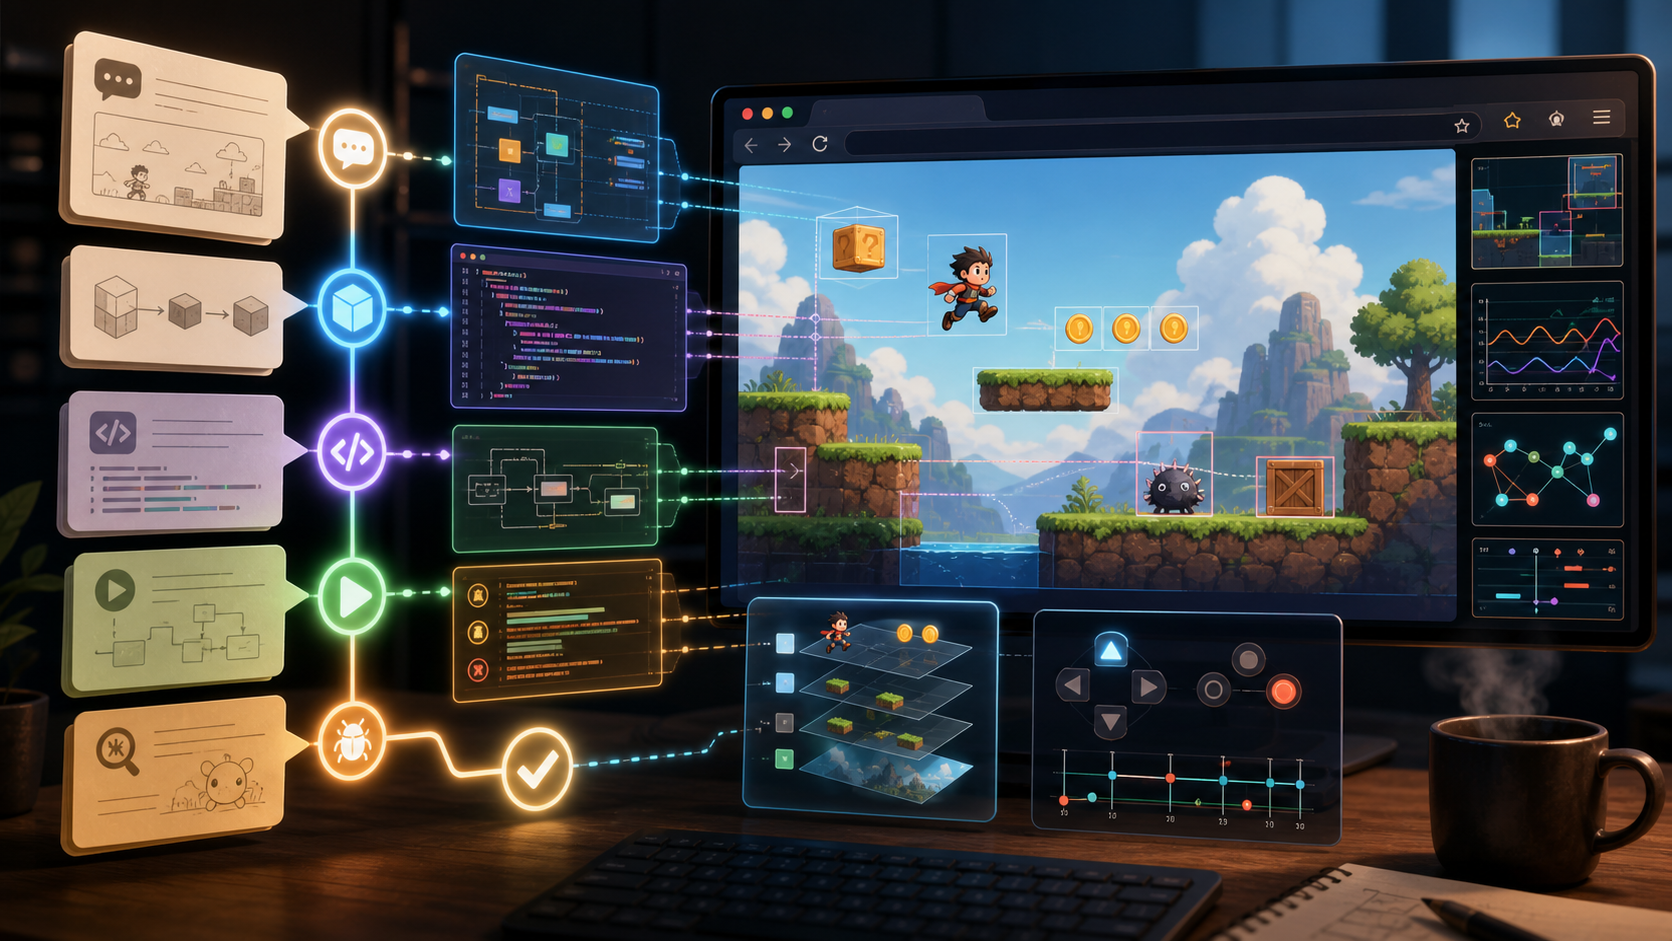
OpenGame이 뉴스가 되는 이유는 AI 게임 생성을 흔한 스크린샷 데모에서 한 걸음 밀어냈기 때문이다. 이 시스템의 주장은 모델이 게임처럼 보이는 장면을 그릴 수 있다는 것이 아니다. 에이전트가 자연어 요청을 받아 구조를 고르고, 여러 파일로 된 브라우저 게임을 만들고, 실행하고, 고치고, 결과가 여전히 프롬프트와 맞는지 판단할 수 있다는 것이다.
게임에는 더 정직한 접근이다. 플레이 가능한 게임은 그림과 코드의 합이 아니다. 업데이트 루프, 입력 처리, 충돌, 타이밍, 점수, 장면 전환, 에셋 로딩, 실패 상태, 그리고 첫 인상이 지나간 뒤에도 플레이어가 목표를 이해할 만큼의 일관성이 필요하다.
CUHK MMLab 연구진의 논문은 OpenGame을 엔드투엔드 웹 게임 생성을 위한 공개 에이전트 프레임워크로 소개한다. 공개 GitHub 저장소에 따르면 프레임워크는 2026년 4월 21일 공개됐고, 현재는 커맨드라인 headless 모드로 동작한다. 사용자가 프롬프트를 주면 에이전트가 프로젝트를 생성하고, 결과물은 브라우저 게임으로 열 수 있다.
핵심 설계는 Game Skill이다. Template Skill은 재사용 가능한 프로젝트 골격을 제공하고 요청을 적절한 게임 구조로 보낸다. Debug Skill은 생성된 게임을 샌드박스에서 실행해 통합 오류와 깨진 상호작용을 잡고, 검증된 수정법을 적용한다. 저장소 README는 템플릿이 canvas, Phaser, three.js 등 여러 웹 게임 구조를 겨냥할 수 있다고 설명한다. 다만 벤치마크 비교에서는 모든 기준 모델에 Phaser 3 사용을 지시해, 각 모델이 단일 파일 스크립트로 빠지는 대신 소프트웨어 엔지니어링 능력을 비교하도록 했다.
OpenGame은 GameCoder-27B도 함께 제시한다. 논문은 이 게임 개발용 코드 모델이 지속 사전학습, 지도 미세조정, 실행 기반 강화학습의 3단계를 거쳤다고 설명한다. 중요한 것은 모델 크기보다 피드백 목표다. 게임 코드는 실행되고, 렌더링되고, 입력에 반응해야 한다. 그럴듯해 보이는 코드만으로는 부족하다.
벤치마크 쪽이 더 강한 신호다. OpenGame-Bench는 플랫폼 게임, 탑다운 슈터, 퍼즐, 아케이드 클래식, 전략 등 다섯 장르에서 150개 브라우저 게임 과제를 평가한다. 각 프롬프트는 완전한 디자인 명세로 취급된다. 생성된 프로젝트는 headless browser에서 제공되고, 빌드와 런타임 실패를 확인한 뒤 Build Health, Visual Usability, Intent Alignment라는 세 가지 0-100 지표로 평가된다.
이 지표들은 스크린샷이 숨기는 실패를 분리한다. Build Health는 프로젝트가 컴파일되고, 로드되고, 치명적 오류 없이 렌더링되는지 본다. Visual Usability는 움직임과 화면 신호를 VLM 판단과 결합해 본다. Intent Alignment는 출력물이 단순히 활기 있어 보이는지가 아니라, 프롬프트에서 나온 요구사항을 충족했는지 측정한다.
논문의 주요 결과 표에서 OpenGame은 Claude Sonnet 4.6과 함께 실행될 때 Build Health 72.4, Visual Usability 67.2, Intent Alignment 65.1을 기록했다. 저자들은 이를 Claude Sonnet 4.6을 쓰는 Cursor의 66.8, 61.4, 58.9와 비교한다. GameCoder-27B를 쓴 OpenGame은 63.9, 57.0, 54.1로 Claude 기반 구성보다 낮지만, 논문은 이 구성이 직접 생성 방식의 공개 및 비공개 LLM 기준선보다 Build Health와 Intent Alignment에서 높았다고 설명한다.
순위표보다 중요한 것은 ablation 결과다. hook-driven implementation을 제거하면 Build Health는 10.1점, Intent Alignment는 11.6점 떨어진다. three-layer reading strategy를 제거하면 Intent Alignment가 8.6점 내려간다. Game Skill ablation에서는 완전한 진화형 템플릿 라이브러리와 living debug protocol을 함께 쓴 구성이 72.4, 67.2, 65.1에 도달했고, 정적 골격과 정적 디버그 체크리스트만 쓴 구성은 60.5, 54.8, 51.2에 머물렀다.
이는 에이전트 래퍼가 실제 일을 하고 있음을 시사한다. OpenGame은 단순히 더 큰 모델에게 더 많은 코드를 쓰라고 하지 않는다. 코드가 들어갈 위치를 제한하고, 검증된 게임 구조를 재사용하고, 반복되는 런타임 실패를 다시 쓸 수 있는 수정 지식으로 바꾼다.
아직 공개성의 빈틈은 있다. GitHub 저장소는 Apache-2.0 라이선스로 공개돼 있고 CLI 사용법, 설정 문서, 데모를 제공한다. 하지만 README에는 OpenGame-Bench 평가 파이프라인이 아직 공개 예정이라고 적혀 있다. 벤치마크 하네스와 생성 결과를 외부에서 완전히 재현하기 전까지, 논문 수치는 유용한 신호이지만 커뮤니티 공용 테스트베드라고 보기는 이르다.
IP 문제도 남아 있다. 공개 데모와 README 예시는 Marvel, Harry Potter, Star Wars, Squid Game처럼 익숙한 엔터테인먼트 IP에 강하게 기대고 있다. 데모를 즉시 이해시키는 데는 효과적이지만, 프롬프트-게임 시스템을 알아볼 수 있는 세계를 재현하는 능력만으로 평가해서는 안 된다는 점도 보여준다. 제품 수준의 게임 생성기라면 권리 인식 에셋 정책, 안전 검사, 배포 규칙이 필요하다.
생성형 게임 플랫폼의 진짜 이정표는 일회성 플레이 가능 페이지가 아니다. 상태를 일관되게 유지하고, 생성 후 편집을 지원하고, 서버가 규칙 판정을 책임지며, 멀티플레이 동기화를 처리하고, 에셋을 조정하고, 제작자가 첫 테스트 세션 뒤에 루프를 개선할 수 있느냐가 핵심이다.
OpenGame의 가장 큰 기여는 그 방향을 가리킨다는 점이다. AI 게임 생성을 스캐폴딩, 코딩, 실행, 디버깅, 측정, 기억의 에이전트 소프트웨어 워크플로로 다룬다. 프롬프트-게임 시스템이 지속 가능한 제품이 된다면, 그 모습은 인상적인 영상 모음보다 이런 구조에 가까울 가능성이 높다.
이 한국어 기사는 영어 원문을 번역한 것이며, 번역 과정에서 오류가 있을 수 있습니다. 이 글은 Wonder Bricks AI Agent의 도움을 받아 작성했으며 SunnyLabs가 편집했습니다.